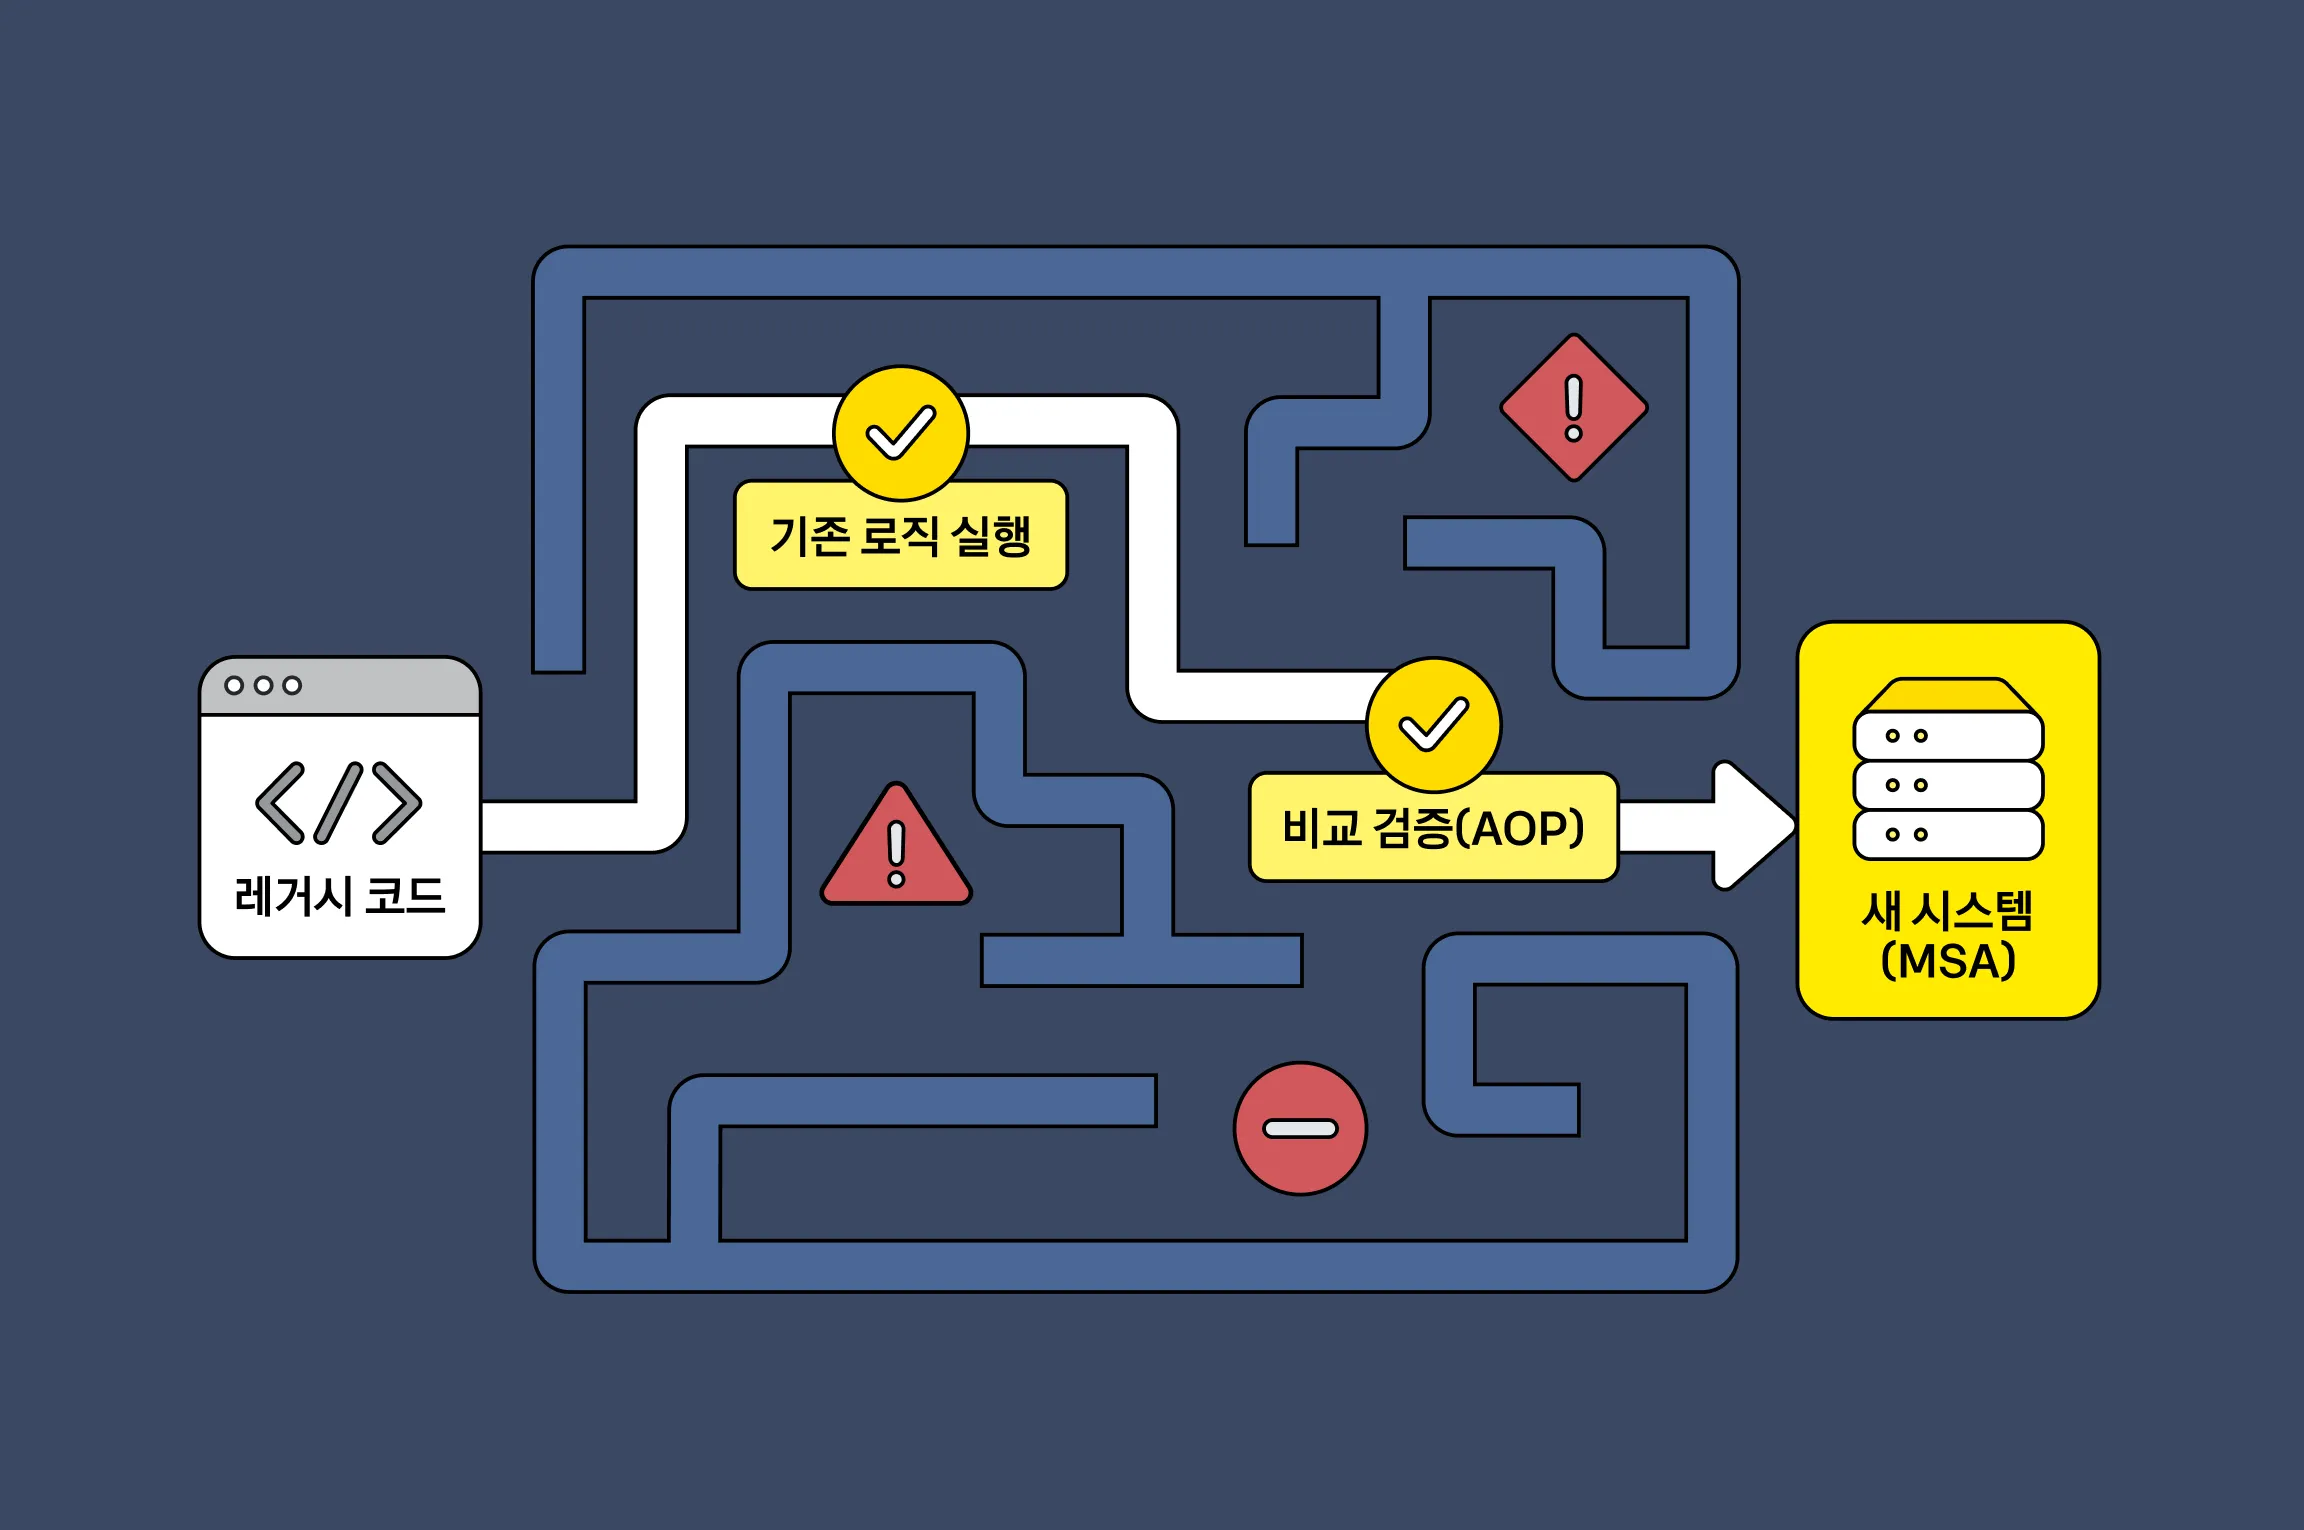
요약: Alloy 메모리 limit을 늘리지 않고 중복 수집과 재수집 문제를 개선했어요. 수집 방식·레이블·청크·캐시를 함께 튜닝한 결과, 샌드박스에서 Loki CPU 사용량은 98%, 쿼리 P99는 90% 감소했어요.
시작하며
Kubernetes에서 Alloy와 Loki를 운영하며 OOM(Out of Memory, 메모리가 부족해 프로세스가 강제 종료되는 것)이나 조회 지연을 겪는 분들을 위해, 중복 수집을 찾아낸 과정과 레이블 설계를 바꾼 기준을 공유해요.
로그 조회가 느리고 Alloy OOM이 계속 발생하니 메모리를 증설하자는 가벼운 제보로 시작했는데, Alloy 메모리 limit은 한 톨도 올리지 않은 채 수집 안정성과 조회 성능을 크게 개선했어요.
| 지표 | Before | After | 변화 |
|---|---|---|---|
| 활성 스트림 | 4,024 | 899 | -78% |
| Loki 총 CPU | 16.9 cores | 0.37 cores | -98% |
| 쿼리 P99 | 0.245s | 0.025s | -90% |
| 24h 범위 쿼리 벤치 | 12.6s | 0.56s | -96% |
파이프라인 한눈에
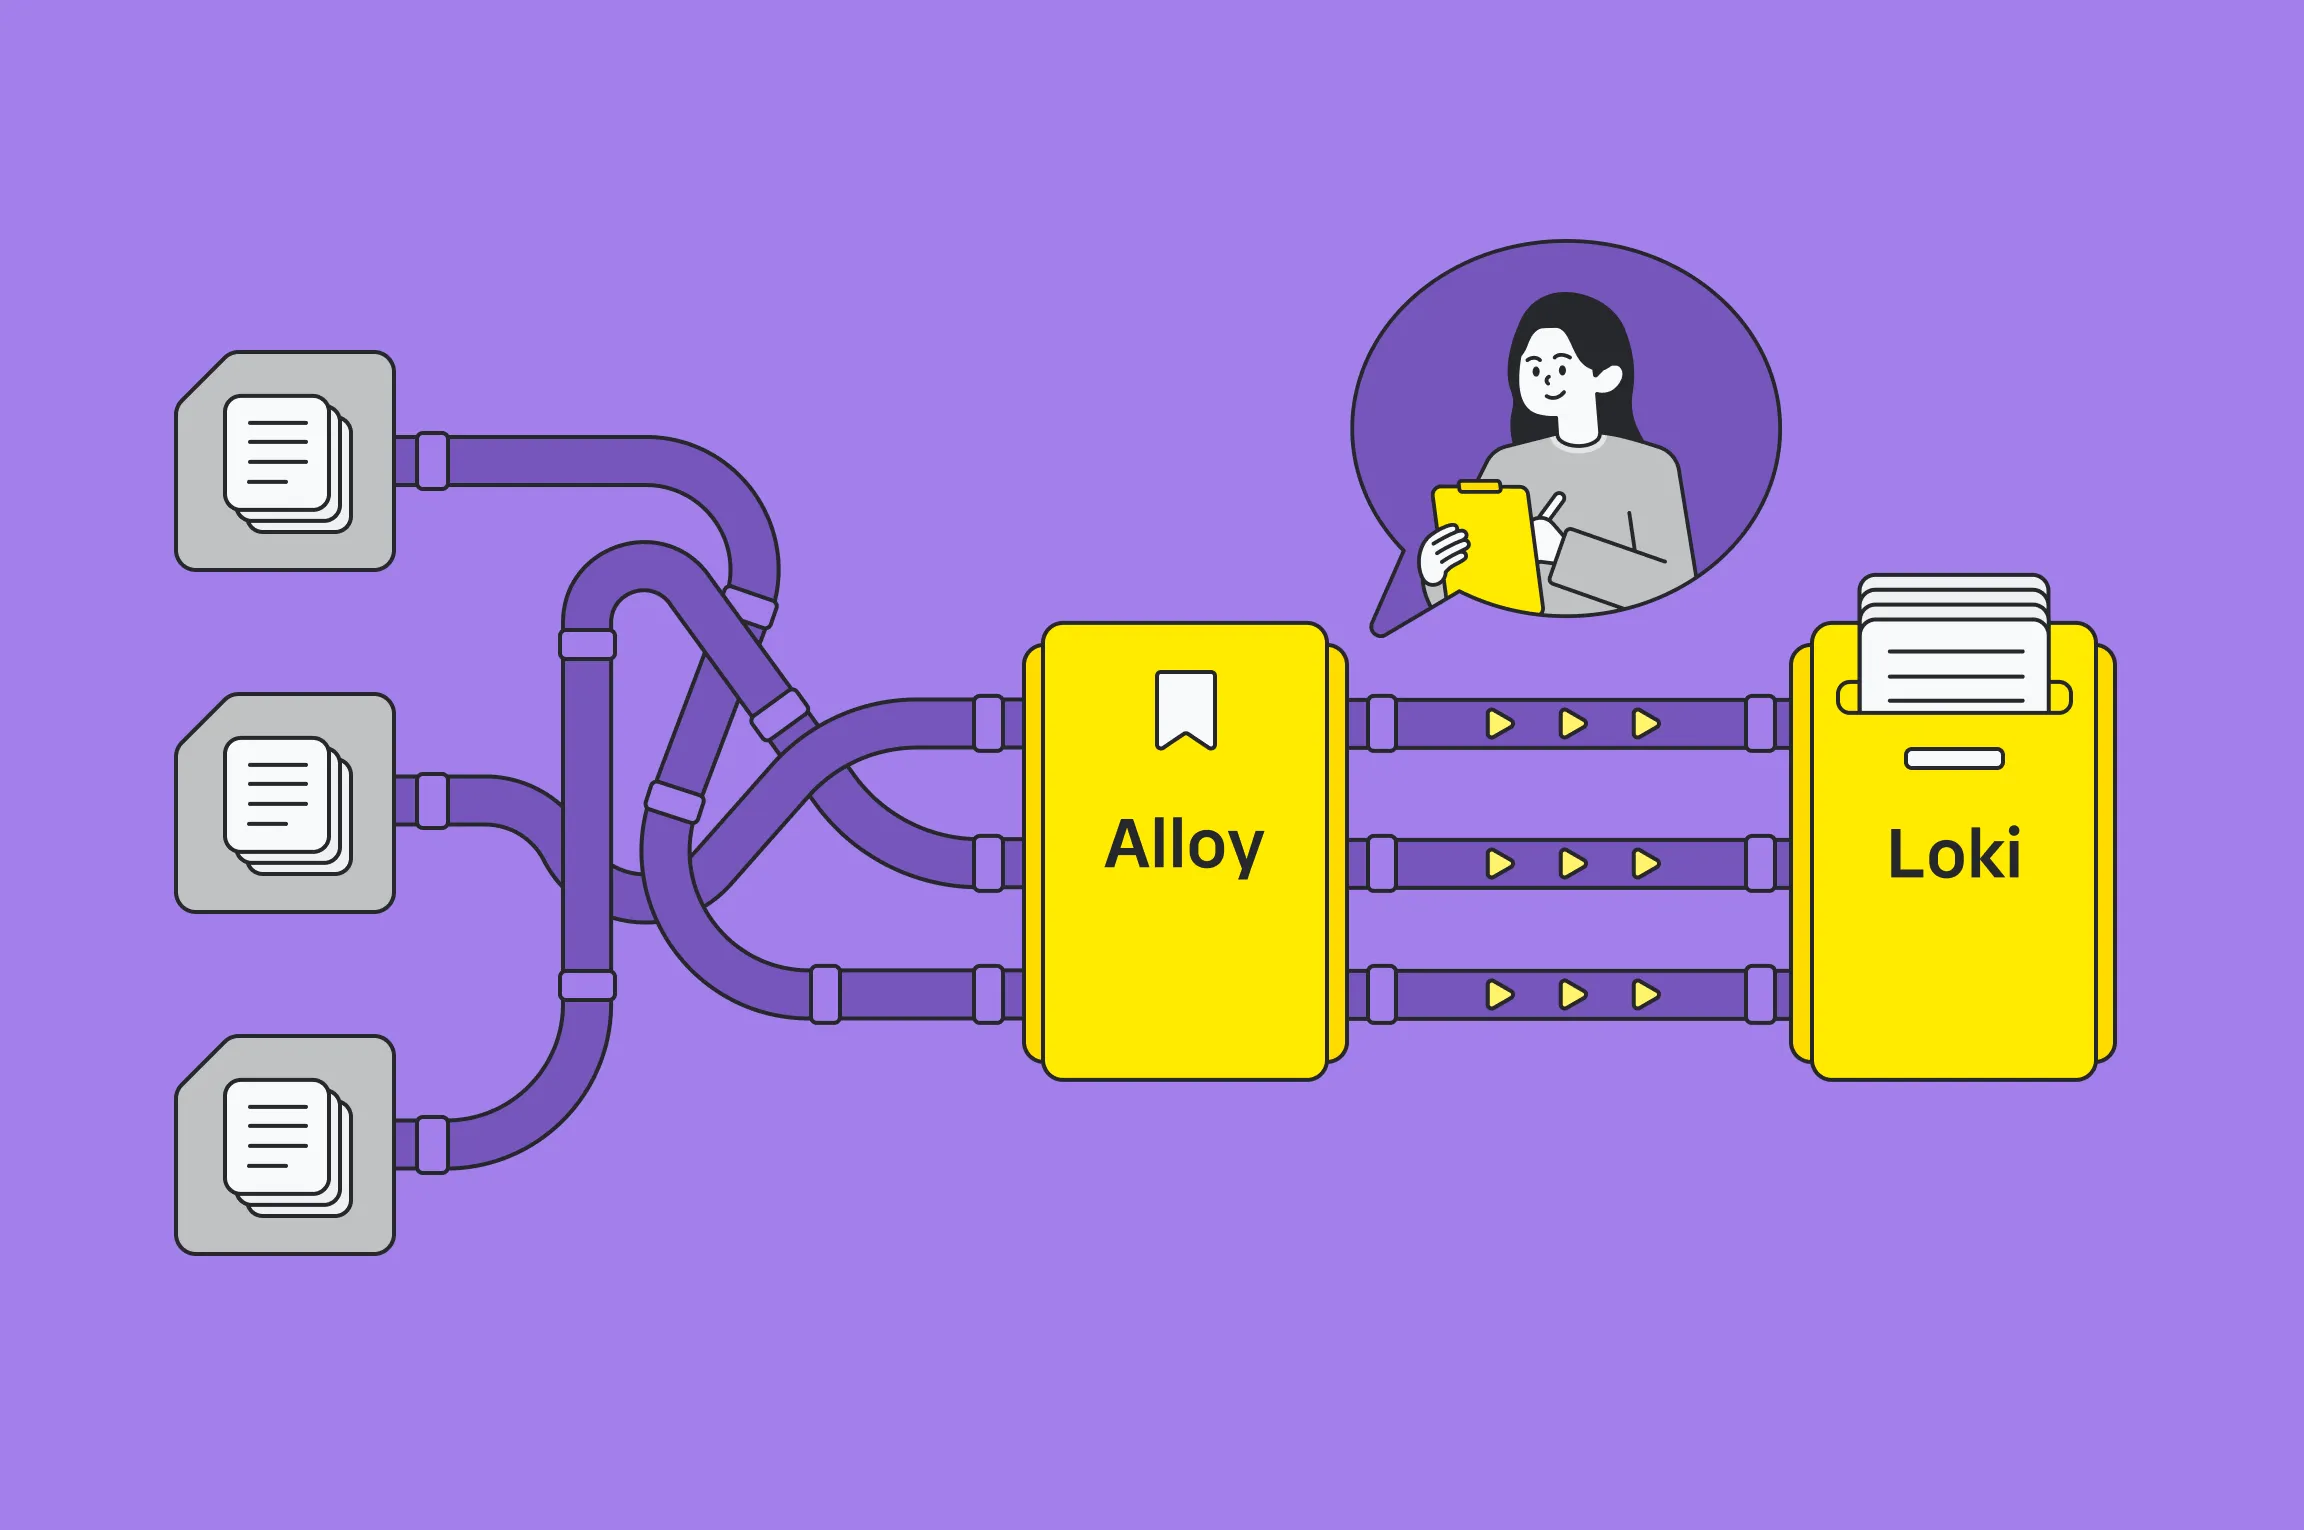
Alloy는 각 노드에 배치되어 로그를 수집하는 역할, Loki는 그 로그를 적재·인덱싱·조회하는 역할이에요. 이 글은 이 둘의 경계에서 무슨 일이 있었는지에 대한 이야기예요.
 Alloy는 각 노드에서 로그 수집을 담당하고, Loki는 각 노드가 아닌 중앙 노드에서 적재·인덱싱·조회를 담당해요. 튜닝은 두 군데: ①Alloy→Loki 전송 방식, ②Loki가 인덱싱하는 레이블에서 이뤄졌어요.
1. 배경: 왜 튜닝이 필요했나
우리 카카오페이손해보험의 모든 중요 서비스는 EKS(AWS의 관리형 Kubernetes 서비스) 클러스터에서 서빙 중이에요. 로그와 메트릭 또한 옵저버빌리티(로그·메트릭·트레이스로 시스템 상태를 파악하는 능력) 파이프라인을 구성하여 수집하고 있어요. 금융감독원 규제 대상 로그는 정해진 보관 기간에 맞춰 철저하게 수집·보관하고 있어요. 그런데 크루(동료 개발자를 부르는 사내 호칭)들에게서 로그 조회가 너무 느리다는 제보가 들어오면서 옵저버빌리티 스택 전반에 대해 최적화를 고민했어요. 점점 커지고 있는 워크로드 규모에 맞춰 옵저버빌리티 파이프라인의 Capacity만 늘리면 될 것 같았지만, 그렇게 우아하게 해결될 상황이 아니었어요.
- 하루에 발생하는 로그 볼륨이 1.3TB/day였어요. 당시 문서 기준으로 Loki SimpleScalable 모드에 권장되는 규모(약 1TB/day)1를 넘어선 수치예요.
크루들이 로그를 조회하는 윈도우 사이즈,초당 발생하는 로그의 양,우리 청크 사이즈(여러 로그를 묶어 저장하는 데이터 단위)가 서로 맞지 않아요.- 파이프라인 자체가 불안정했어요. 로그 수집기 Pod의 메모리가 계속 우상향하다 OOM으로 컨테이너가 재시작되기를 반복하고 있었어요.
2. 수집기에서 먼저 발견한 병목
Alloy OOM 이슈를 더 자세히 확인해 보니, Loki로의 전송 실패로 인한 재시도/드롭이 누적 수억 건씩 쌓이고 있었어요. 받는 쪽(Loki)도 확인해 봤지만, write 경로 지표에서는 자원 포화가 보이지 않았고, Alloy의 메모리만 주기적으로 상한에 다다르고 있었어요.
Loki write 현황 (로그 적재 담당)
- Memory 18% · CPU 11% (limit 6Gi)
- ingester(들어온 로그를 메모리에서 청크로 구성해 저장하는 컴포넌트) append 실패 0건
- GOMEMLIMIT(Go 런타임의 소프트 메모리 한도) 무제한
Alloy 현황 (로그 수집 담당)
- 메모리 limit 근처로 우상향 - 2Gi에 95% (Loki write는 6Gi에 18%)
- 누적 드롭 카운터 8.9억 건 - Alloy가 Loki로 전송하지 못하고 버린 로그 엔트리 수의 누적값이에요. 같은 로그의 재전송이나 재수집이 중복 집계됐을 수 있어, 고유 로그 8.9억 건이 유실됐다는 뜻은 아니에요.
- GOMEMLIMIT 1,843Mi 자동 설정 - 2Gi limit의 90%로 Alloy Helm 차트가 자동 설정한 값
Loki write:  mem 18% · cpu 11% (6Gi limit) · append 실패 0 · GOMEMLIMIT 무제한
Alloy:       mem 95% (2Gi limit) · 누적 drop 8.9억 · GOMEMLIMIT 1,843Mi (힙1,153+스택229)
이 시기에는 Alloy의 작은 설정 변경 하나를 반영하는 Terraform apply도 한 번에 1시간씩 걸렸어요. OOM 재시작이 반복되면서 rollout이 안정화되지 못한 영향으로 추정해요.
튜닝이 먼저가 아니라 정상화하는 것이 먼저라는 판단에 따라 “Alloy를 과로시키는 구조적 원인 제거”를 가장 시급한 첫 목표로 잡았어요.
전송 실패의 원인부터 찾기 위해 Alloy 설정을 자세히 살펴봤어요.
3. Alloy가 과로하고 있던 이유
제일 먼저, Alloy에 쌓이고 있는 에러 로그를 유심히 관찰해 보니 두 가지 에러 로그가 끝없이 쌓이고 있었어요.
a. 중복 수집으로 늘어난 API 요청
I0326 06:15:08 request.go:752] "Waited before sending request"
delay="1.163926088s"
reason="client-side throttling, not priority and fairness"
verb="GET" URL=".../pods/.../log?follow=true×tamps=true"Alloy가 Kubernetes에서 로그를 가져오는 방식은 크게 두 가지예요.
- 파일 방식(
loki.source.file): 노드 머신별로 생성되고 있는 로그 파일을 그대로 읽어서 보내요. - API 방식(
loki.source.kubernetes): Kubernetes API 서버에 Pod 로그 스트림을 요청(GET .../log?follow=true)해서 받아와요.
우리는 2번(API 방식)을 쓰고 있었는데, 여기에 clustering 옵션이 꺼져 있었어요(default = false)2.
Alloy는 모든 EKS 노드에 DaemonSet(대상 노드마다 Pod를 1개씩 배치하는 워크로드)으로 떠 있어요. clustering이 켜져 있으면 “이 Pod는 내가, 저 Pod는 옆 Alloy가” 하는 식으로 서로 담당을 나눠요. 당시 discovery 대상이 클러스터 전체 Pod였기 때문에, 이 옵션이 꺼진 각 Alloy는 클러스터 전체 Pod 로그를 자기 혼자 다 요청했어요. 노드가 20개면, 같은 Pod 로그 하나를 20개의 Alloy가 각자 Kubernetes API에 요청하는 셈이 되니, 한 번만 수집해도 될 일을 20번 중복 수집하는 것이었어요.
이 중복 요청이 두 군데에 그대로 부하로 꽂혔어요.
- kube-apiserver로 가는 요청 쪽: 요청이 폭증하자 Alloy의 Kubernetes 클라이언트가 자체 속도 제한(client-side throttling)에 걸려 “요청을 기다렸다”는 위 경고가 끝없이 쌓였어요. reason에 적힌 그대로 API 서버가 거부한 게 아니라 클라이언트가 스스로 속도를 줄인 것인데, 그만큼 보내려는 요청 자체가 많았다는 신호예요.
- Loki 쪽: 같은 로그를 20개 Alloy가 각자 push하니, Loki가 받는 write 요청 자체가 그만큼 부풀려졌어요.
정리하면 clustering 설정 하나가 꺼져 있던 탓에, Alloy가 수집(Kubernetes API)과 전송(Loki) 양쪽에서 동시에 과로하고 있었던 거예요.
b. 오래된 로그 재수집과 Loki의 거부 응답
다음으로 함께 찍히고 있는 “entry too far behind” 에러와 drop entries 수의 원인을 찾아봤어요.
ts=2026-03-26T06:15:11.982Z level=error msg="final error sending batch" component=loki.write.default
  status=400
  error="server returned HTTP status 400 Bad Request (429): entry too far behind, oldest acceptable timestamp is: 2026-03-25T06:15:11.000Z"
tenant=prod stream="{namespace=\"batch\", pod=\"legacy-worker-7f9c8\"}"Loki가 push를 거부하면 그 사유가 Alloy 쪽 로그에 찍히는데, 여기서도 entry too far behind, entry not sent 에러가 끊임없이 쌓이고 있었어요. 이상한 건 에러 내용이었어요. 마지막 배포가 한참 전인 Pod의, 그것도 아주 오래된 시점 로그가 지금 막 들어오고 있었어요. 왜 지금 와서 몇 달 전 로그를 새로 수집하고 있는 건지부터 고민했어요.
파일 수집 방식에서는 각 로그 파일을 어디까지 읽었는지 position 파일에 기록하고, 재시작하면 그 위치부터 이어 읽어요3. position 파일이 책갈피 역할을 하는 셈이에요. 당시 Alloy의 저장 경로는 Pod의 emptyDir에 연결되어 있었어요. emptyDir는 Pod 생명주기에 묶인 임시 볼륨이라, 컨테이너만 재시작되는 OOM에서는 유지되지만 재배포나 노드 교체로 Pod 자체가 재생성되면 함께 사라져요. 수집기 재시작·재배포 이후 오래된 로그가 다시 들어오는 현상은 반복해서 관찰했지만, API 소스의 어떤 상태가 어느 재시작 경로에서 유실됐는지까지 분리해서 확인하지는 못했어요.
Alloy가 kube-apiserver에 보내는 요청을 debug 레벨로 확인했을 때, 조회 시작 시점을 제한하지 않는 로그 요청이 관찰됐어요. 이 과정에서 다시 들어온 오래된 로그는 Loki의 허용 시점보다 과거여서 거부됐어요. 다만 마지막 배포가 2년 전이라고 해서 2년치 로그가 모두 반환되는 것은 아니에요. 실제 반환 범위는 노드에 남아 있는 로그 파일과 로테이션 범위에 따라 달라요.
오래된 로그의 재수집과 메모리 증가, OOM이 반복되는 양상을 보며 재수집 부하가 수집기 불안정을 키운다고 판단했어요. 다만 상태 유실과 OOM 사이의 정확한 인과관계는 당시 관측만으로 확정하지 못했어요.
4. 중복 수집과 재시작 악순환 끊기
이 상황을 타파하기 위해 세 가지 작업을 함께 배포했어요. 그래서 아래 변화는 개별 효과가 아니라 세 변경의 합산 효과예요.
- clustering을 켜서 중복 수집을 제거했어요.
- 수집 소스 자체를 파일로 바꿔 Pod 로그 스트림 조회 API 의존을 없앴어요.
- 읽기 위치(position)를
hostPath에 영속화했어요.
이 작업의 배포 전후로 Loki가 받던 부하(샌드박스) 변화가 극명했어요.
| 구분 | 초당 로그 인입량 | Loki 네트워크 수신 (RX) | Loki 네트워크 송신 (TX) |
|---|---|---|---|
| 배포 전 (2026-03-12) | 1.27 MB/s | 13.60 MB/s | 12.47 MB/s |
| 배포 후 (2026-03-26) | 0.09 MB/s | 1.53 MB/s | 1.52 MB/s |
a. clustering { enabled = true }
같은 로그에 대해서는 여러 Alloy가 수집하지 않도록 clustering { enabled = true } 옵션을 활성화했어요.
loki.source.kubernetes의 타깃을 Alloy 인스턴스 간에 샤딩(분업)하도록 해 중복 수집을 제거하는 옵션이에요.
세 변경을 함께 배포한 뒤 Loki pusher request 지표에서도 변화가 보였어요. Loki가 받던 요청 수도, Alloy의 CPU 점유율도 기존 대비 10% 수준으로 줄어들었지만, 이를 clustering 활성화만의 효과로 분리해 측정한 것은 아니에요.
b. loki.source.kubernetes → loki.source.file
Alloy를 EKS의 노드마다 한 개씩 배포했던 본래 의도는, 각 머신별로 담당이 되어서 그 노드에서 발생하는 로그만 수집하게 하는 것이에요.
늦게나마 그 의도를 제대로 구현했어요. Kubernetes API로 로그 내용을 조회하는 대신, 각 Alloy가 자기 노드 /var/log/pods/ 파일을 직접 tail(파일에 추가되는 내용을 이어 읽기)하는 것이에요.
그 결과 Pod 로그 내용을 조회하는 API 요청(GET .../log?follow=true)이 사라져서, Kubernetes control plane에 가해지던 무의미한 부하를 없앴어요. Pod 목록을 watch하는 discovery 요청은 계속 남지만, 로그 스트림 조회에 비하면 훨씬 가벼워요.
잘못 설계된 로그 파이프라인이 Kubernetes API 전반에 부하를 가하고 있었단 사실이 미안하기도 했고 속이 너무너무 시원했어요.
현재 설정 (After) - 파일 기반 노드-로컬 수집
discovery.kubernetes "pod" { role = "pod" }        // Pod "목록"만 watch (로그 내용 X)

discovery.relabel "pod_logs" {
  targets = discovery.kubernetes.pod.targets
  rule {                                            // Pod UID → 로컬 파일 경로
    source_labels = ["__meta_kubernetes_pod_uid"]
    target_label  = "__path__"
    replacement   = "/var/log/pods/*$1/*/*.log"
  }
}
local.file_match "pod_logs" { path_targets = discovery.relabel.pod_logs.output }
loki.source.file  "pod_logs" {
  targets    = local.file_match.pod_logs.targets
  forward_to = [loki.write.default.receiver]
}
- discovery는 API로 Pod 목록만 watch해서 가볍고, 로그 내용은 노드 파일에서 읽어요
__path__가 노드 로컬 경로라, 그 노드에 실제 존재하는 파일만 match되어 자연히 노드-로컬이 돼요- 파일 수집에서는 이 노드-로컬 매칭만으로 중복이 제거돼요. a의 clustering은 API 방식을 쓰던 단계의 중복을 끊는 역할이었고, 파일 수집의 전제 조건은 아니에요.
- 마운트:
/var/log/pods(hostPath, readOnly) - 메모리 limit을 늘리는 게 아니라 부하를 줄여서 해결했어요
c. 읽기 위치를 영속화해 재수집 방지
재시작·재배포 이후 오래된 로그가 다시 들어오는 현상을 막기 위해, 파일 수집으로 전환하면서 읽기 위치의 보존도 함께 개선했어요. 앞서 관찰한 API 소스의 재수집 원인을 확정한 것과는 별개로, 새 파일 수집 구성에서 상태 유실을 방지하는 작업이었어요.
position 파일 저장 경로를 emptyDir에서 노드의 hostPath(노드 파일시스템 경로를 Pod에 연결하는 볼륨)로 옮겨서, Pod가 재시작·재생성돼도 읽기 위치가 노드 디스크에 남도록 했어요.
Pod가 같은 노드에 다시 뜨면 책갈피 위치부터 이어서 수집해요. 노드 자체가 교체되면 position도 사라지지만, 그 노드의 로그 파일도 함께 사라지므로 재수집할 과거 로그가 없어요.
적용 후에는 재시작이 일어나도 전체 기간 재수집과 entry too far behind 거부가 더는 관찰되지 않았어요.
5. 레이블 카디널리티도 손봐야 한다
수집단을 고쳐 Alloy를 안정화했지만 이 논의의 출발점이던 “로그 조회가 느려요”는 이제야 시작이었어요. 공식 문서를 통해 도움을 얻으며 조사해 본 결과, 우리의 문제는 “카디널리티”였어요. Loki의 비용과 성능에는 로그 양, 스트림 수, 청크 크기, 쿼리 범위가 함께 영향을 주는데, 우리 병목은 카디널리티(서로 다른 레이블 조합의 수), 즉 스트림(동일한 레이블 조합을 가진 로그 묶음)의 개수였어요. 스트림이 많아지면 인덱스가 비대해지고, 청크가 잘게 쪼개져 조회가 느려집니다.
Loki 공식 문서4에서 하지 말라는 형태로 수집하는 곳이 몇 군데 있었어요.
계속 바뀌는 값을 레이블에 넣지 마세요. (공식 문서 권고를 요약한 의역)
활성 스트림 수:              4,024개
`app` 레이블 "오염":          105 / 206  (51%)
max_global_streams_per_user: 0 (무제한)app레이블 오염 51%:app레이블은 워크로드를 식별하기 위해 가장 직관적으로, 가장 자주 사용되는 레이블이에요. 여기서 “오염”은 controller 이름 같은 안정적인 값 대신 ReplicaSet 해시처럼 배포마다 바뀌는 고카디널리티 값이 섞여 들어간 것을 말해요. 전체app값 206개 중 105개가 이런 값이었고, 레이블 하나가 스트림 수를 크게 불리고 있었어요.- 무제한 스트림(
= 0): 활성 스트림 수의 상한이 없으니 카디널리티가 폭발해도 막아 줄 가드레일이 없었어요.
6. 레이블 체계를 재설계하자!
자주 쓰는 쿼리의 검색 범위를 좁히도록 레이블을 정리하는 것이 목표였어요. 우리가 가장 자주 조회하는 형태를 먼저 파악하고, 거기에 맞춰서 레이블 체계를 정리하는 작업을 진행했어요. 무엇을 인덱싱할지보다, 필요 없는 인덱싱을 지우는 것이 이번 작업의 핵심이었어요. 레이블별 실제 사용 흔적을 찾고 개발자 크루들, SRE 크루들과 “정말 쓰는가”에 대해 긴 시간 논의했어요. (이 과정이 전체 과정 중 가장 오래 걸렸던 것 같아요.)
인덱스 레이블과 우리 크루들이 자주 쿼리하는 형태를 조사해 보니 다음과 같은 문제가 있었어요.
- 유용할 것이라고 생각해 구축 초기에 넣어 둔 인덱스 레이블 중 상당수가 미사용 상태였어요.
- 같은 값이 여러 레이블에 포함되어 있는 경우도 많았어요.
- EKS 외의 로그 출발지(EC2, CloudWatch, IDC 자체 데이터센터)와는 로그 레이블 체계가 달라서 쿼리하기 불편했어요.
그래서 다음과 같은 세 가지 작업을 진행했어요.
- 인덱스 레이블과 Structured Metadata 분리
app레이블 오염 제거 (relabel)- 불필요한 DEBUG 로그 줄이기
작업 이후 모든 개발 직군 크루들에게 새로운 쿼리 방법을 안내하고, 기존 스트림 선택자 방식으로는 조회할 수 없게 된 레이블(Structured Metadata 필터로 조회 방법이 바뀐 레이블)을 사용 중인 Grafana dashboard를 하나하나 찾아 수정했어요.
a. 인덱스 레이블과 Structured Metadata 분리
- 쿼리가 잦고 반드시 사용되어야 하는 레이블 —> 아주 제한적으로 인덱스 레이블에 남겼어요.
- 쿼리를 종종 하긴 하지만 성능에 지장을 주는 레이블 —> 모두 Structured Metadata5(스트림을 정의하는 인덱스에 넣지 않고 로그와 함께 저장하는 메타데이터)로 옮겼어요. Structured Metadata는 schema v13(TSDB)과 Loki 3.0 이상에서 지원돼요.
stage.static_labels {          // 저카디널리티 → 인덱스 레이블
  values = { cluster = "...", vpc = "...", provider = "aws", network = "..." }
}
stage.structured_metadata {    // 고카디널리티 → 메타데이터로 강등 (조회는 유지)
  values = { namespace="", pod="", filename="", stream="",
             detected_level="", dag_id="", job_name="" }
}
stage.label_drop {             // 인덱스(스트림 정의)에서 제외
  values = ["filename","stream","container_runtime","job",
            "namespace","pod","dag_id","job_name","service_name"]
}쿼리는 다음처럼 바뀌어요.
# 변경 전: 인덱스 레이블 선택자로 조회
{namespace="payment", app="order-api"}

# 변경 후: namespace는 Structured Metadata 필터로 조회
{app="order-api"} | namespace="payment"
b. app 레이블 오염 제거 (relabel)
app에 붙던 ReplicaSet 해시(-5b7b7d9d8d)를 정규식으로 벗겨 controller 이름만 남겨 스트림 폭증을 차단했어요.
rule {                          // discovery.relabel "pod_logs"
  source_labels = ["__meta_kubernetes_pod_controller_name"]
  regex         = "^(.+)-[a-z0-9]{8,10}$"   // pod-template-hash 제거
  target_label  = "__tmp_controller_name"
}
rule {                          // controller 이름을 app 레이블로
  source_labels = ["__tmp_controller_name"]
  target_label  = "app"
}[a-f0-9]로는 일부 해시를 놓쳐요. 또 해시가 아닌데 이름이 우연히 패턴에 맞는 controller가 변형되지 않는지, 적용 전에 매칭 결과를 확인하는 게 안전해요.
c. 불필요한 DEBUG 로그 줄이기
레이블을 정리해도 S3가 안 줄어드는 이상한 상황이 있었어요. 원인은 레이블이 아니라 로그 레벨이었어요.
불필요하게 DEBUG 레벨로 로그를 찍고 있던 앱들이 있었고, 이게 3개월치 누적으로 28TB나 쌓여 있었어요.
detected_level로 앱별 로그 레벨 분포를 뽑아서 DEBUG 비중이 비정상적으로 높은 앱을 확인하고, 하나씩 찾아가서 로그 레벨을 INFO로 조정했어요.
7. 결과 (Before → After)
결과를 읽기 전에
- 측정 조건: 성능 지표는 샌드박스 클러스터(Before 2026-01 측정), 자원·네트워크 지표는 프로덕션 클러스터(Before 2026-04-09 측정) 기준이에요. 두 표는 측정 클러스터가 달라요.
- 동시 변경: 같은 기간에
max_chunk_age(4h→168h) 조정, chunks-cache(조회 시 청크를 다시 읽는 비용을 줄이는 캐시) 증설, DEBUG 로그 레벨 정리(6장)가 몇 주에 걸쳐 겹쳐서 배포됐어요. - 해석 한계: 아래 %는 수집 방식·레이블링만의 효과가 아니라 그 기간 전체 튜닝의 합산 효과예요. “증설 없음”도 Alloy 메모리 limit에 한정된 이야기예요(chunks-cache는 증설했어요). 특히 S3 -86%는 레이블 재설계가 아니라 DEBUG 로그 정리(3개월치 28TB)와 규제 보관 대상이 아닌 로그의 retention(보관 기간) 단축이 만든 결과예요.
Loki, Alloy 성능 지표 변화 (샌드박스 클러스터)
| 지표 | Before (2026-01) | After (2026-06-05/06-10) | 변화 |
|---|---|---|---|
| 활성 스트림 | 4,024 | 899 | -78% |
app 레이블 오염 | 51% (105/206) | 9% (20/214) | -42%p |
| Loki 총 CPU | 16.9 cores | 0.37 cores | -98% |
| Loki 쿼리 P99 | 0.245s | 0.025s | -90% |
| S3 버킷 크기 | 32.9 TB | 4.54 TB | -86% (DEBUG 로그 정리 + retention 단축 효과, 레이블링 효과 아님) |
| 24h 범위 쿼리 벤치 | 12.6s | 0.56s | -96% |
| 1h 범위 쿼리 벤치 | 0.165s | 0.115s | -30% (아직 청크가 자잘하게 쪼개져 있어 개선 폭이 작아요. 미해결 과제) |
자원·네트워크 지표 변화 (프로덕션 클러스터)
| 지표 | Before (2026-04-09) | After (2026-06-10) | 변화 |
|---|---|---|---|
| 활성 스트림 | 2,891 | 1,725 | -40% |
| Loki 총 CPU | 7.20 cores | 1.25 cores | -83% |
| Loki 네트워크 RX | 140.7 MB/s | 9.3 MB/s | -93% |
| Loki ingest rate | 16.3 MB/s | 0.97 MB/s | -94% |
| Alloy RSS (평균, 실제 상주 메모리) | 1,172 Mi | 564 Mi | -52% |
| Alloy CPU (평균) | 0.290 cores | 0.057 cores | -80% |
| Alloy push P99 | 236 ms | 52 ms | -78% |
 네트워크 계열(RX -93%, ingest -94%)이 가장 깊게 깎였고, Alloy 자원(RSS -52%, CPU -80%)은 limit 증설 없이 내려간 수치예요. 네트워크 RX와 ingest rate는 집계 범위가 다른 별개 지표예요.
마치며
-
“옵저버빌리티의 옵저버빌리티”를 확보하자. 조용히 잘 수집하고 있을 줄만 알았던 Alloy와 Loki가 이렇게 문제가 많았어요. Alloy와 Loki가 생산하는 메트릭도 이번에야 처음으로 제대로 수집하고 분석하는 계기가 되었어요. 로그 파이프라인도 여러 제품의 연결로 운영되기에, 어디가 병목인지 면밀하게 파악해야 한다는 것을 배웠어요.
-
그럴듯한 기본값이 부채일 수 있다. Alloy와 Loki에 별다른 설정 없이 기본값으로 배포하면 그냥저냥 중간은 하고 있을 줄 알았던 것이 패착이었어요. 적지 않은 규모이다 보니 튜닝되지 않은 Helm 차트는 우리 워크로드 규모에 맞지 않아 불필요한 리소스를 쓰는 구성이 되어 있었어요.
-
스케일업의 유혹을 앞으로도 이겨내자. Alloy의 limit을 늘려 달라는 요청을 받고, 늘리기 전에 한 번만 더 살펴보자는 취지에서 이 작업을 시작했어요. 근본적인 원인을 먼저 확인해야겠다는 스스로의 결정이 뿌듯해요.
-
여러 변경을 한 번에 밀어넣으면, 나중에 “무엇이 정말 효과가 있었는지”를 나 자신도 설명 못 하게 된다. 수집 방식 전환 · 레이블링 ·
max_chunk_age· chunks-cache 증설 · S3 정리를 겹쳐서 배포하다 보니, 결과는 화려한데 각 %를 어디에 귀속시켜야 할지 뒤늦게 다시 뜯어봐야 했어요. 다음번엔 최소한 측정 시점만이라도 변경 단위로 쪼개야겠어요.
이제 열심히 정한 레이블 규칙이 잘 지켜지도록 지속적으로 가이드하고, 크루들의 쿼리 형태에 맞게 Loki 청크 사이즈를 조절하는 일이 남았네요.
참고 자료
Footnotes
-
loki.source.kubernetes레퍼런스 —helm pull grafana/alloy기준 확인(appVersion v1.18.1). ↩