요약: Querydsl을 활용한 대량 데이터 처리 전략을 정리합니다. Count 쿼리 병목, Offset 풀 스캔 문제, 커서 기반 페이지네이션, Batch Insert/Update 등 실측 데이터를 기반으로 한 최적화 방법을 다룹니다.
💡 리뷰어 한줄평
wi.fi 대량 데이터를 읽고 쓰는 과정에서 발생하는 병목을 차례로 해결하며, 안전하고 고성능인 서비스를 만들기 위한 가이드입니다.
시작하며
일반적으로 어드민 페이지처럼 데이터를 테이블 뷰 형식으로 제공할 때는 페이징 기법으로 현재 페이지의 내용과 페이지 정보를 표시합니다. JPA와 Querydsl을 활용하면 이런 반복적인 코드를 비교적 쉽게 작성할 수 있습니다.
데이터 모수가 적고 단순한 구조라면 문제가 없지만, 데이터가 많아지고 여러 테이블을 조인해서 조회해야 하는 구조라면 이야기가 달라집니다. 이 글은 Querydsl로 페이징을 처리하는 가장 단순한 형태에서 출발해 Count 쿼리 병목을 마주치고, 이를 Slice와 코루틴 병렬 처리로 걷어냅니다. 그럼에도 남는 offset의 구조적 한계를 발견하고, 커서 기반 페이지네이션에 도달하기까지의 과정을 하나의 흐름으로 정리합니다.
그리고 여기서 멈추지 않습니다. 대량 데이터를 빠르게 읽어 왔다면, 그 데이터를 저장하고 수정하는 쓰기 구간이 다음 병목이 됩니다. 글의 후반부에서는 Querydsl-SQL의 Batch Insert/Update로 쓰기 병목까지 해결하며, 읽기부터 쓰기까지 대량 데이터 처리의 전체 흐름을 완성합니다.
출발점: Querydsl과 Support 클래스
개발을 하다 보면 다양한 조회 쿼리를 만들게 됩니다. 이 글이 다루는 읽기 성능 개선과 쓰기 성능 개선 모두, 결국 Querydsl을 프로젝트에 어떻게 구조화해서 쓰느냐는 질문에서 출발합니다.
그런데 앞으로 다룰 기능들은 조회 메서드 하나에 머물지 않습니다. Count 쿼리를 병렬로 던지는 로직, Slice의 hasNext 판별, 커서 조건을 붙이는 로직은 조회 메서드마다 똑같은 형태로 반복됩니다. 그래서 성능 이야기를 본격적으로 시작하기 전에, 이런 기능을 한곳에 모아 둘 자리를 먼저 만들어 두겠습니다. Repository 구현체에는 조회 쿼리만 남기고 반복되는 처리 로직은 상위 Support 클래스가 받아 주는 구조로, 세부 구현체를 숨기고 Repository 인터페이스를 통해 조회 기능을 제공할 수 있다는 장점도 함께 따라옵니다. 이 절에서 만드는 Support 클래스는 글 전반부의 조회 기능들이 차례로 얹히는 토대이고, 후반부의 쓰기 성능 개선은 JPA가 아닌 Querydsl-SQL 경로를 쓰기 때문에 별도 구성으로 다룹니다.
기능을 얹을 자리: QuerydslRepositorySupport
Spring Data JPA는 Repository 구현체에서 Querydsl을 쓰기 위한 QuerydslRepositorySupport를 이미 제공합니다. EntityManager와 Querydsl 유틸리티를 주입받아 두기 때문에, 이 클래스를 상속하는 것만으로 확장의 출발점을 얻을 수 있습니다.
다만 기본 제공 범위는 넓지 않습니다. QuerydslRepositorySupport는 JPQLQuery를 이용해 JPQL 작업을 진행하는 구조라, 쿼리를 from으로 시작하는 형태만 제공합니다. 우리가 SQL을 쓸 때처럼 select, selectFrom으로 시작하려면 JPAQueryFactory가 필요한데 이건 기본 제공에 없습니다.
그래서 이 클래스를 상속한 Support 클래스를 직접 정의하고, 필요한 기능을 하나씩 채워 넣습니다. 이 절에서는 그 첫 번째 기능으로 select, selectFrom을 얹어 보면서 앞으로 기능을 추가해 나갈 방식을 잡아 두겠습니다.
첫 번째 기능: select와 selectFrom
abstract class Querydsl4RepositorySupport(domainClass: Class<*>) : QuerydslRepositorySupport(domainClass) {

    protected var queryFactory: JPAQueryFactory by Delegates.notNull()

    @PersistenceContext
    override fun setEntityManager(entityManager: EntityManager) {
        this.queryFactory = JPAQueryFactory(entityManager)
        super.setEntityManager(entityManager)
    }

    protected fun <T> select(expr: Expression<T>): JPAQuery<T> {
        return queryFactory.select(expr)
    }

    protected fun <T> selectFrom(from: EntityPath<T>): JPAQuery<T> {
        return queryFactory.selectFrom(from)
    }
}EntityManager는 상위 클래스에서 전달받아 JPAQueryFactory를 만들고, JPAQuery가 제공하는 select, selectFrom을 protected 메서드로 열어 둡니다. Repository 구현체는 이 Support를 상속하기만 하면 두 메서드를 바로 쓸 수 있습니다.
import com.example.querydsl.domain.QPayment.payment as qPayment

class PaymentCustomRepositoryImpl : Querydsl4RepositorySupport(Payment::class.java), PaymentCustomRepository {

    override fun findUseSelectFrom(targetAmount: BigDecimal): List<Payment> {
        return selectFrom(qPayment)
            .where(qPayment.amount.gt(targetAmount))
            .fetch()
    }

    override fun findUseSelect(targetAmount: BigDecimal): List<Long> {
        return select(qPayment.id)
            .from(qPayment)
            .where(qPayment.amount.gt(targetAmount))
            .fetch()
    }
}selectFrom은 조회하는 타입이 일치하는 경우 사용할 수 있고, select는 반환받을 타입을 지정할 수 있습니다. 우리가 흔히 쓰는 SQL 문과 아주 유사한 구조입니다.
테스트로 정상 동작을 확인합니다.
@Test
internal fun `findUseSelectForm`() {
    //given
    val targetAmount = 200.toBigDecimal()

    //when
    val payments = paymentRepository.findUseSelectFrom(targetAmount)

    //then
    then(payments).allSatisfy(
        Consumer {
            then(it.amount).isGreaterThan(targetAmount)
        }
    )
}select, selectFrom으로 시작한다고 해서 성능상 큰 이득이 생기는 것은 아닙니다. 여기서 중요한 건 기능 자체가 아니라 기능을 얹는 방식입니다. 필요한 기능을 Support 클래스의 메서드로 추가하고, Repository 구현체는 상속만으로 그 기능을 가져다 쓰는 구조입니다. 이 글에서 다룰 페이징, Slice, 병렬 Count 로직도 모두 같은 방식으로 이 클래스에 차례로 얹힙니다.
이제 이 Support 위에 실제 서비스에서 가장 많이 쓰이는 기능, 페이징을 얹어보겠습니다. 데이터가 늘어날수록 가장 먼저 발목을 잡는 것은 Count 쿼리입니다.
첫 번째 병목: Count 쿼리
데이터 모수가 적고 조회 구조가 단순할 때는 Querydsl의 applyPagination 메서드를 활용하면 페이징 로직을 쉽게 작성할 수 있습니다.
기본 페이징 구현
class OrderCustomRepositoryImpl : QuerydslRepositorySupport(Order::class.java), OrderCustomRepository {

    override fun findPagingBy(
        pageable: Pageable,
        address: String
    ): Page<Order> {
        val query: JPAQuery<Order> = from(order).select(order).where(order.address.eq(address))
        val content: List<Order> = querydsl.applyPagination(pageable, query).fetch()
        val totalCount: Long = query.fetchCount()
        return PageImpl(content, pageable, totalCount)
    }
}
앞서 살펴본 QuerydslRepositorySupport를 기반으로 JpaRepository를 확장해 페이징 로직을 구현했습니다.
세부 구현체의 조회 로직을 보면, Querydsl을 기반으로 JPAQuery를 생성하며 필요한 조회 조건을 작성합니다. 이 쿼리 객체를 그대로 이용해 Content 조회와 전체 레코드 수 조회를 차례로 수행합니다.
참고: 여기서 사용한
fetchCount()는 Querydsl 5.0부터 Deprecated 되었습니다. 사유와 대체 방식은 뒤의 “Count 쿼리를 따로 최적화하기” 절에서 다룹니다.
실제 실행되는 쿼리를 확인해보겠습니다.
select order0_.id as id1_4_, ...
    order0_.address as address4_4_, order0_.created_at as created_2_4_, order0_.updated_at as updated_3_4_,
from orders order0_
where order0_.address = ?
limit ?, ?

select count(order0_.id) as col_0_0_
from orders order0_
where order0_.address = ?
Content 조회에 필요한 쿼리와 전체 레코드 조회에 필요한 쿼리를 JPAQuery 하나로 동일하게 사용할 수 있고, applyPagination 메서드로 offset·limit 관련 페이징 로직을 간단히 구현할 수 있다는 게 큰 장점입니다.
applyPagination을 활용하면 개발 생산성 측면에서 분명한 이점이 있습니다. 그러나 모든 개발 결정에는 트레이드오프가 따릅니다. 편리한 기능을 즉시 쓸 수 있는 대신, 나중에 이자를 포함한 비용을 치러야 할 수도 있습니다. 어떤 문제가 발생하는지 살펴보겠습니다.
Count는 왜 병목인가
Count 쿼리는 특정 조건에 해당하는 전체 레코드 수를 조회하는 구조라, 데이터 총량이 늘어날수록 성능 저하가 발생할 수 있습니다. Content를 조회하는 limit·offset 쿼리는(offset이 비교적 크지 않은 초반 구간에서는) 빠르게 처리되는 반면, Count 쿼리는 시간이 오래 걸려 병목이 될 수 있습니다. 여러 테이블을 조인해서 조회하는 경우에는 조회 조건이 복잡해져 정확한 인덱스를 타기 어려워지는 문제도 함께 발생합니다. 이는 조회 조건에 부합하는 전체 레코드를 Count하는 구조에서 필연적으로 발생하는 문제입니다.
Content 쿼리를 Count에 재사용하면 손해다
Content 조회 쿼리와 레코드 Count 조회 쿼리를 JPAQuery 하나로 동일하게 처리하면 성능적인 손해가 발생할 수 있습니다. 특히 여러 테이블을 조인해서 데이터를 조회하는 경우에 이 문제가 더 두드러집니다.
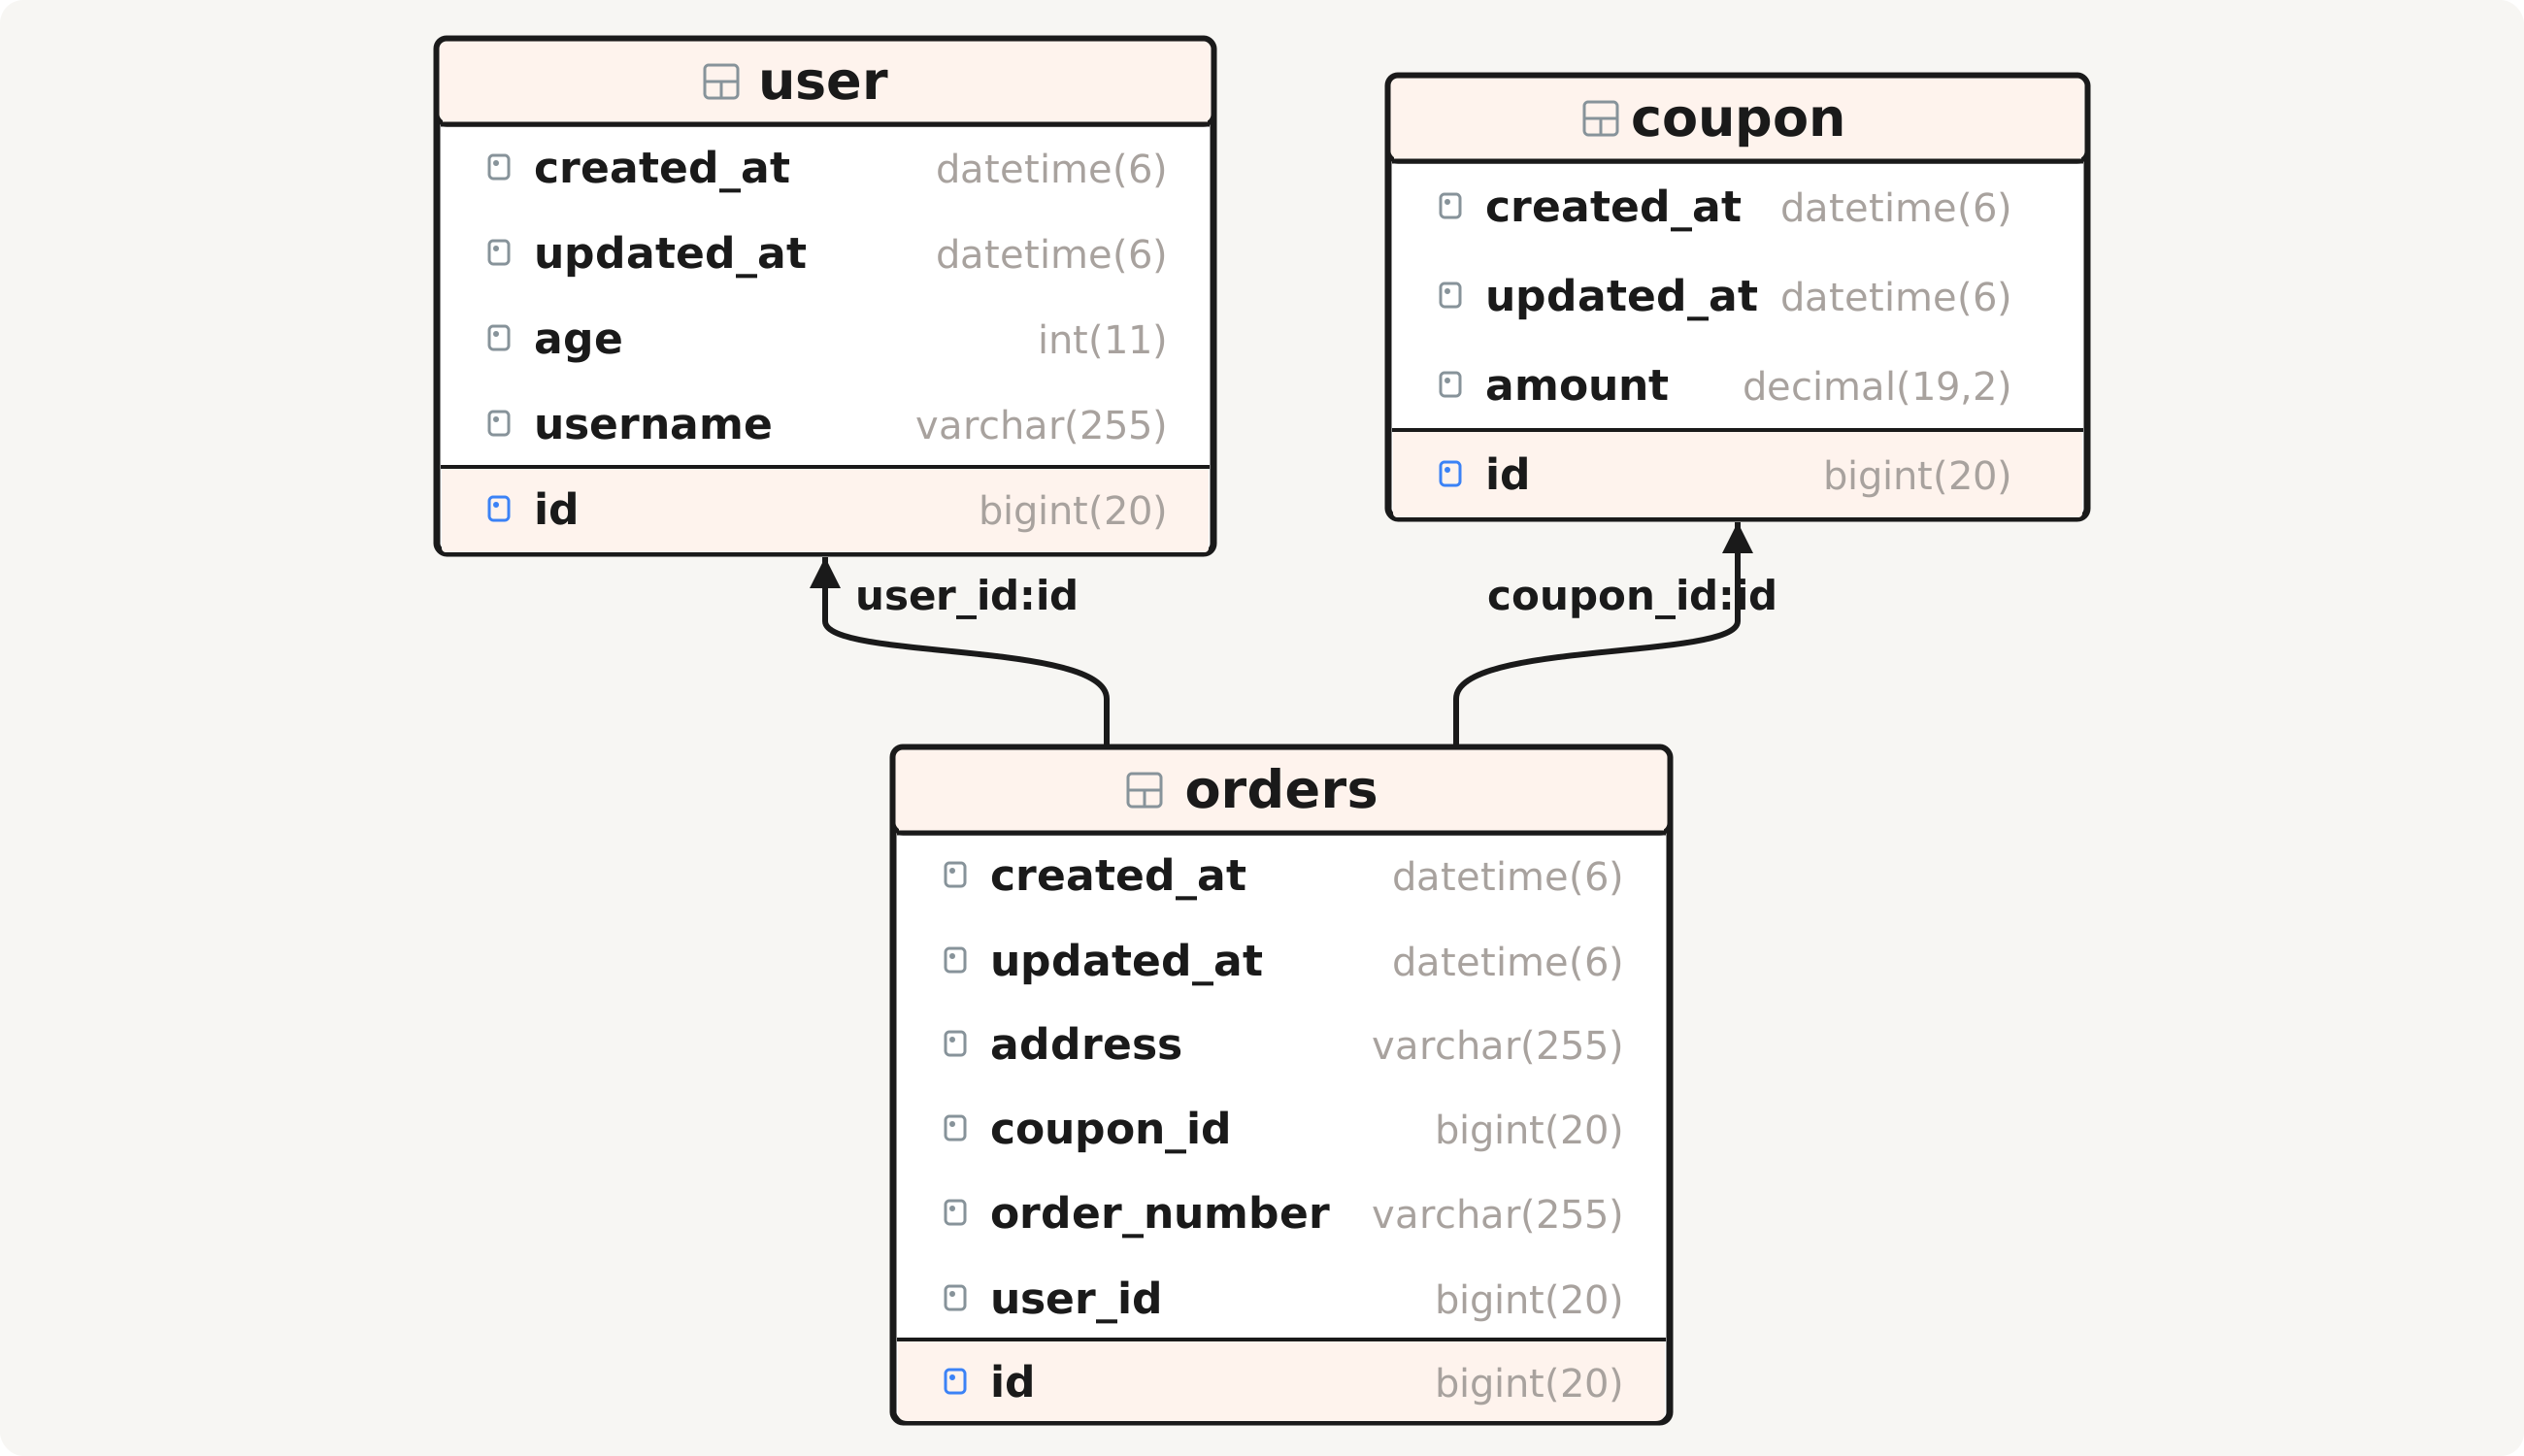
주문을 조회할 때 사용자 및 쿠폰 정보를 함께 내려줘야 하는 상황이라도, 조회 필터에 주문 정보만 있다면 Count 쿼리는 다른 테이블과의 조인 없이 주문 테이블만으로 작성하는 것이 효율적입니다.
다만 이 최적화에는 전제가 있습니다. 조인을 제거해도 Count 결과가 동일해야 합니다. 조인 대상 테이블이 Content 쿼리의 결과 행 수를 바꾸지 않는 경우에만 성립합니다. 예제처럼 주문(N) 쪽에서 사용자·쿠폰(각 1) 쪽으로 이어지는 다대일(N:1)·일대일(1:1) 조인은 주문 한 건당 조인되는 행이 최대 1건뿐이므로 행 수가 늘어나지 않아 안전합니다. 반면 주문(1)에서 주문 상품(N)처럼 일대다(1:N)로 이어지는 조인이 INNER JOIN이라면 결과 행 수가 늘어나기 때문에, 조인을 걷어내면 Count 값 자체가 달라집니다. 이런 조인은 Count에도 남겨야 합니다. 또한 FK 무결성이 보장되지 않는 환경에서는 다대일이라도 조인 결과에 유령 행이 생길 수 있으며, LEFT JOIN은 인덱스 무결성에 따라 결과가 달라질 수 있으므로 조인 제거 전 쿼리 결과를 반드시 검증해야 합니다.
-- Content 조회 쿼리
select o.*,
       u.*,
       c.*
from orders o
         left join coupon c on o.coupon_id = c.id
         inner join user u on o.user_id = u.id
where o.address = ?
limit ?, ?
;

-- Content 조회 쿼리를 그대로 사용하는 경우
select count(o.id)
from orders o
         left join coupon c on o.coupon_id = c.id
         inner join user u on o.user_id = u.id
where o.address = ?
;

-- Content 쿼리를 사용하지 않고 별도의 Count 조회 쿼리
select count(o.id) as count
from orders o
where o.address = ?
;
주문 조회에서 address 필드만 조회 조건에 해당한다면, 사용자·쿠폰 테이블과의 조인은 필요하지 않습니다. 이 경우 Count 쿼리는 주문 테이블만을 대상으로 간단하게 작성하는 것이 효율적입니다. 앞서 언급한 전제, 즉 조인이 결과 행 수를 바꾸지 않는 관계(다대일·일대일)일 때만 조인 제거가 가능하다는 점은 동일하게 적용됩니다. 조회 조건이 복잡해질수록, Count 쿼리를 별도로 작성하는 편이 성능적으로 유리합니다.
Count를 걷어내는 두 가지 방법
Count 쿼리로 인한 병목은 크게 두 갈래로 풀 수 있습니다. Count 쿼리 자체를 아예 실행하지 않거나(Slice), 앞서 살펴본 것처럼 Count 쿼리를 Content 쿼리와 분리해 조건에 맞게 최적화하는 것입니다.
Slice: Count를 아예 실행하지 않기
그렇다면 Count 쿼리가 반드시 필요할까요? 실제로 페이지 네비게이션이 있는 화면이라도, 사용자가 26페이지에 원하는 데이터가 있을 것이라고 예상하고 바로 넘어가는 경우는 거의 없습니다. 대부분 다음 페이지로 넘어가는 방식으로 탐색합니다. 이런 경우라면 무거운 Count 쿼리 없이, 다음 데이터가 있는지 여부만 내려주는 Slice 방식(전체 개수 없이 ‘다음 페이지 존재 여부’만 내려주는 페이징 방식)이 더 효율적입니다.
JPA Slice 방식은 Page 방식과 달리 Total Count를 조회하는 쿼리를 실행하지 않습니다. 대용량 데이터의 페이징 처리에 특히 유용하며, Total Count가 꼭 필요한 데이터인지 비즈니스적으로 확인해보고 필요하지 않다면 사용하지 않는 것을 권장합니다.
Spring Data는 Slice를 통해 Total Count를 조회하지 않는 페이징 처리를 지원합니다. 처음 떠올리기 쉬운 구현은 이런 모습입니다.
class OrderCustomRepositoryImpl : QuerydslRepositorySupport(Order::class.java), OrderCustomRepository {
    override fun findSliceBy(pageable: Pageable, address: String): Slice<Order> {
        val query: JPAQuery<Order> = from(order).select(order).where(order.address.eq(address))
        val content: List<Order> = querydsl.applyPagination(pageable, query).fetch()
        val hasNext: Boolean = content.size >= pageable.pageSize
        return SliceImpl(content, pageable, hasNext)
    }
}
Total Count가 없으니 남은 문제는 하나입니다. 다음 페이지가 있는지 없는지를, Count 없이 어떻게 알 수 있을까요? 위 구현은 요청한 pageSize만큼 조회한 뒤 content.size >= pageable.pageSize로 hasNext를 판단합니다. 그런데 이 판단은 함정이 있습니다.
Order 데이터가 총 22건 있고, size를 22로 요청했다고 가정해보겠습니다.
| 구현 | 총 22건, 요청 size | 반환 Content | hasNext | 판정 |
|---|---|---|---|---|
content.size >= pageSize | 22 | 22 | true | ✗ 다음 페이지가 없는데 있다고 답함 |
요청한 22건이 정확히 22건 반환됐다는 이유만으로 hasNext가 true가 되어 버립니다. 실제로는 더 읽을 데이터가 없는데도 “다음 페이지가 있다”고 잘못 응답하는 것입니다. Count 없이 다음 페이지 존재 여부를 판단하려면, 딱 그만큼만 읽어서는 안 됩니다.
해결책은 간단합니다. 한 건 더 읽어보는 것입니다. pageSize + 1개를 조회해서, 실제로 pageSize를 초과하는 데이터가 있는지로 hasNext를 판단합니다.
protected fun <T> applySlicePagination(
    pageable: Pageable,
    query: Function<JPAQueryFactory, JPAQuery<T>>
): Slice<T> {
    val jpaContentQuery = query.apply(queryFactory)
    val content = querydsl!!.applyPagination(pageable, jpaContentQuery)
        .limit((pageable.pageSize + 1).toLong()) // applyPagination이 건 limit을 덮어씀
        .fetch()
    val hasNext = content.size > pageable.pageSize
    return SliceImpl(content.take(pageable.pageSize), pageable, hasNext)
}applyPagination이 이미 설정한 limit을 pageSize + 1로 다시 덮어쓰고, 판정 기준도 >=에서 >로 바꿉니다. 대신 호출자에게는 초과분 1건이 새어 나가면 안 되므로 take(pageSize)로 실제 반환 분량을 다시 잘라 냅니다.
같은 22건, size 5 기준으로 다시 확인해보겠습니다.
| Page | 요청 size | 실제 조회 | 반환 Content | hasNext |
|---|---|---|---|---|
| 0~3 | 5 | 6 | 5 | true |
| 4 | 5 | 2 | 2 | false |
Page 4에서는 남은 데이터가 2건뿐이라 pageSize + 1(6건)을 요청해도 2건만 돌아오고, 2 > 5가 거짓이므로 hasNext는 정확히 false가 됩니다. Count 쿼리를 실행하지 않고도, 그리고 끝까지 읽어보지 않고도 — 한 건만 더 읽어보면 다음 페이지 존재 여부를 정확히 판단할 수 있습니다.
이
+1조회 기법은 뒤에서 다룰 커서 기반 페이지네이션(applyCursorPagination)에서도 동일하게 등장합니다.
Total Count가 반드시 필요하지 않은 화면이라면 대부분 Slice 방식이 효율적입니다. 예를 들어 최근 주문 정보를 기반으로 회원 등급을 업데이트하는 배치 기능이라면 Count 쿼리를 쓸 이유가 없습니다. 단순히 필요한 데이터를 offset과 limit으로 읽고 처리하면 되기 때문입니다. Count 쿼리는 데이터 양에 비례해 시간이 걸리므로, 데이터 양이 많을수록 계속 사용하는 것은 성능상 부담이 됩니다. Spring Batch HTTP Page Item Reader처럼 대량의 데이터를 처리하는 배치 애플리케이션에 API를 제공할 때는 Slice 기반으로 제공하는 것이 성능적으로 유리합니다.
Count 쿼리를 따로 최적화하기
Total Count가 반드시 필요한 경우에는 Slice 방식을 사용할 수 없으므로 Page 방식을 사용해야 합니다. 앞서 살펴봤듯 여러 테이블을 조인해서 복잡한 데이터를 조회하는 경우에는 Count 쿼리를 별도로 구현하는 것이 성능적인 이점을 가져올 수 있습니다.
이는 AbstractJPAQuery의 fetchCount()가 Deprecated되기도 한 이유입니다. JPQL은 서브쿼리 projection을 허용하지 않아 카운트 쿼리를 범용적으로 표현할 방법이 없고, Querydsl은 기존 쿼리를 카운트용으로 재작성하는 방식으로 이를 흉내 내는데, 이 방식은 단순 쿼리에서만 동작합니다. 특히 여러 groupBy 절이나 having 절이 있는 복잡한 쿼리에서는 올바른 카운트를 재작성할 수 없어 잘못된 결과를 내놓을 수 있으며, 이 경우 Querydsl은 카운트를 메모리에서 계산하는 방식으로 폴백하기 때문에 대량 결과 집합에서 심각한 성능 페널티까지 발생합니다. 그래서 조인이 많거나 복잡한 쿼리에서는 Count 쿼리를 다른 방식으로 직접 실행하도록 권장하고 있습니다.
Count 쿼리를 별도로 구현하면 다음과 같이 작성할 수 있습니다.
class OrderCustomRepositoryImpl : QuerydslRepositorySupport(Order::class.java), OrderCustomRepository {
    override fun findPagingBy(pageable: Pageable, address: String): Page<Order> {
        val content: List<Order> = from(order)
            .select(order)
            .innerJoin(user).on(order.userId.eq(user.id))
            .leftJoin(coupon).on(order.couponId.eq(coupon.id))
            .where(order.address.eq(address))
            .run {
                querydsl.applyPagination(pageable, this).fetch()
            }
        val totalCount: Long = from(order)
            .select(order.count())
            .where(order.address.eq(address))
            .fetchFirst()

        return PageImpl(content, pageable, totalCount)
    }
}PageImpl로 Page 객체를 생성할 때, totalCount를 Content 쿼리와 별도로 구현해 작성합니다. totalCount를 구할 때는 SimpleExpression의 count()를 사용해 질의합니다. 최종적으로 실행되는 쿼리를 살펴보겠습니다.
-- Content 쿼리
select order0_.id           as id1_4_,
       order0_.created_at   as created_2_4_,
       order0_.updated_at   as updated_3_4_,
       order0_.address      as address4_4_,
       order0_.coupon_id    as coupon_i5_4_,
       order0_.order_number as order_nu6_4_,
       order0_.user_id      as user_id7_4_
from orders order0_
         inner join user user1_ on (order0_.user_id = user1_.id)
         left outer join coupon coupon2_ on (order0_.coupon_id = coupon2_.id)
where order0_.address = ?
limit ?, ?
;

-- Count 쿼리
select count(order0_.id) as col_0_0_
from orders order0_
where order0_.address = ?
limit ?
;
Content 쿼리는 여러 테이블의 조인을 통해 필요한 정보를 가져오고, Count 쿼리는 조회 조건에 필요한 정보만 가져옵니다. fetchCount()가 Deprecated 되었기 때문에 fetchFirst()로 대체합니다. fetchFirst()는 내부적으로 limit 1을 붙여 실행하는 메서드인데, count()는 단일 행 집계라 limit이 붙어도 결과 값에는 영향이 없습니다. 이렇게 Count 쿼리를 따로 구현하면, Count 조건에 맞는 방식으로 최적화하여 성능적인 이점을 얻을 수 있습니다.
Count와 Content를 동시에: 코루틴 병렬
왜 병렬이 가능한가
Count 쿼리가 1,000ms, 이어지는 Content 쿼리가 500ms 걸린다고 가정하면 순차 실행 시 총 1,500ms가 소요됩니다. 이 작업이 조회할 때마다 반복되면 성능에 문제가 생길 수 있습니다. 그러나 이 두 작업은 서로 의존성이 없기 때문에 병렬로 처리할 수 있습니다.
Count 쿼리와 Content 쿼리를 병렬로 처리하면, Count 쿼리의 소요 시간이 더 길더라도 전체 작업을 1,000ms에 끝낼 수 있습니다. 코루틴으로 병렬 처리를 구현해보겠습니다.
코루틴 구현
findPagingBy 메서드 내에서 코루틴의 async를 사용해 Content 조회 쿼리와 Count 쿼리를 동시에 실행합니다. 병렬 처리를 위해 두 작업 모두 Dispatchers.IO가 제공하는 I/O 전용 스레드에서 실행됩니다.
override fun findPagingBy(pageable: Pageable, address: String): Page<Order> = runBlocking {
    log.info("findPagingBy thread : ${Thread.currentThread()}")
    val content: Deferred<List<Order>> = async(Dispatchers.IO) {
        log.info("content thread : ${Thread.currentThread()}")
        from(order)
            .select(order)
            .innerJoin(user).on(order.userId.eq(user.id))
            .leftJoin(coupon).on(order.couponId.eq(coupon.id))
            .where(order.address.eq(address))
            .run {
                querydsl.applyPagination(pageable, this).fetch()
            }
    }
    val totalCount: Deferred<Long> = async(Dispatchers.IO) {
        log.info("count thread : ${Thread.currentThread()}")
        from(order)
            .select(order.count())
            .where(order.address.eq(address))
            .fetchFirst()
    }
    PageImpl(content.await(), pageable, totalCount.await())
}
JDBC는 블로킹이다
실행 로그를 보면 요청 스레드와 코루틴 스레드가 어떻게 분리되는지 확인할 수 있습니다.
INFO [nio-8080-exec-2] OrderApi: thread api : Thread[http-nio-8080-exec-2,5,main]
INFO [-2 @coroutine#4] OrderCustomRepositoryImpl: findPagingBy thread : Thread[http-nio-8080-exec-2 @coroutine#4,5,main]
INFO [-1 @coroutine#5] OrderCustomRepositoryImpl: content thread : Thread[DefaultDispatcher-worker-1 @coroutine#5,5,main]- 요청 스레드:
OrderApi는 HTTP 요청을 처리하는http-nio-8080-exec-2스레드에서 실행되고,findPagingBy도 이 스레드에서 시작해 코루틴을 생성합니다. - 병렬 실행 스레드:
async(Dispatchers.IO)로 실행되는 content·count 쿼리는 각각 별도의 I/O 전용 워커 스레드에서 동시에 처리됩니다.
이 병렬 처리가 중요한 이유는 JDBC 드라이버가 기본적으로 동기·블로킹 방식으로 동작하기 때문입니다. JDBC 드라이버는 쿼리를 실행하면 호출한 스레드를 블로킹한 채로 결과를 기다립니다. 만약 runBlocking의 컨텍스트(주로 HTTP 요청 스레드)에서 그대로 실행하면, 한 작업이 끝날 때까지 스레드가 점유되어 결국 순차 처리와 다를 바 없게 됩니다. Dispatchers.IO를 사용해 블로킹 작업을 별도의 I/O 전용 스레드 풀로 옮겨야, 서로 다른 스레드에서 동시에 실행되어 실제로 병렬성을 확보할 수 있습니다.
다만 이 병렬 처리에는 전제가 있습니다. QuerydslRepositorySupport가 감싸는 EntityManager는 스레드마다 따로 발급되는 것이 아니라, Spring이 주입하는 하나의 공유 프록시(SharedEntityManagerCreator)입니다. 여기서 공유 프록시란, 실제 EntityManager를 대신 주입받아 호출을 위임하는 객체로, 호출될 때마다 현재 스레드에 맞는 실제 EntityManager를 찾아 연결해 주는 역할을 합니다.
트랜잭션 밖에서는 이 프록시가 호출될 때마다 내부적으로 임시 EntityManager를 얻어 쓰고, 쿼리 실행이 끝나면 반환합니다. 따라서 위 코드처럼 각 코루틴이 from(...)부터 fetch()까지 자신만의 쿼리 체인을 처음부터 끝까지 직접 만들고 실행한다면 결과적으로 안전하게 동시 실행됩니다. 이때 JPAQueryFactory는 스레드 간에 공유해도 되는 불변 상태만 갖는 구성이라 싱글턴으로 공유해 쓰는 것이 일반적이고, JPAQueryFactory의 공식 문서도 싱글턴 등록을 권장합니다. 반면 팩토리가 만들어 주는 쿼리 객체(JPAQuery)는 where/limit/offset이 누적되는 가변 상태이므로 스레드 간 공유는 금물입니다.
또한 @Transactional이 적용된 메서드 안에서 이 패턴을 그대로 쓰면 오히려 반대 문제가 생깁니다. 트랜잭션에 바인딩된 EntityManager는 트랜잭션을 시작한 스레드의 TransactionSynchronizationManager ThreadLocal에만 등록됩니다. 그런데 코루틴이 Dispatchers.IO로 전환하면 이 ThreadLocal이 워커 스레드까지 전파되지 않습니다. 그 결과 각 코루틴은 트랜잭션에 참여하지 못한 채, 앞서 설명한 것과 동일하게 트랜잭션 밖의 임시 EntityManager로 조회를 실행하게 됩니다. 이때 트랜잭션에서 아직 커밋되지 않은 변경을 조회 결과에서 놓치거나, 커넥션을 여러 개 동시에 점유하는 문제가 생길 수 있습니다. 따라서 트랜잭션이 필요한 조회에는 이 패턴을 그대로 적용하지 않도록 주의해야 합니다.
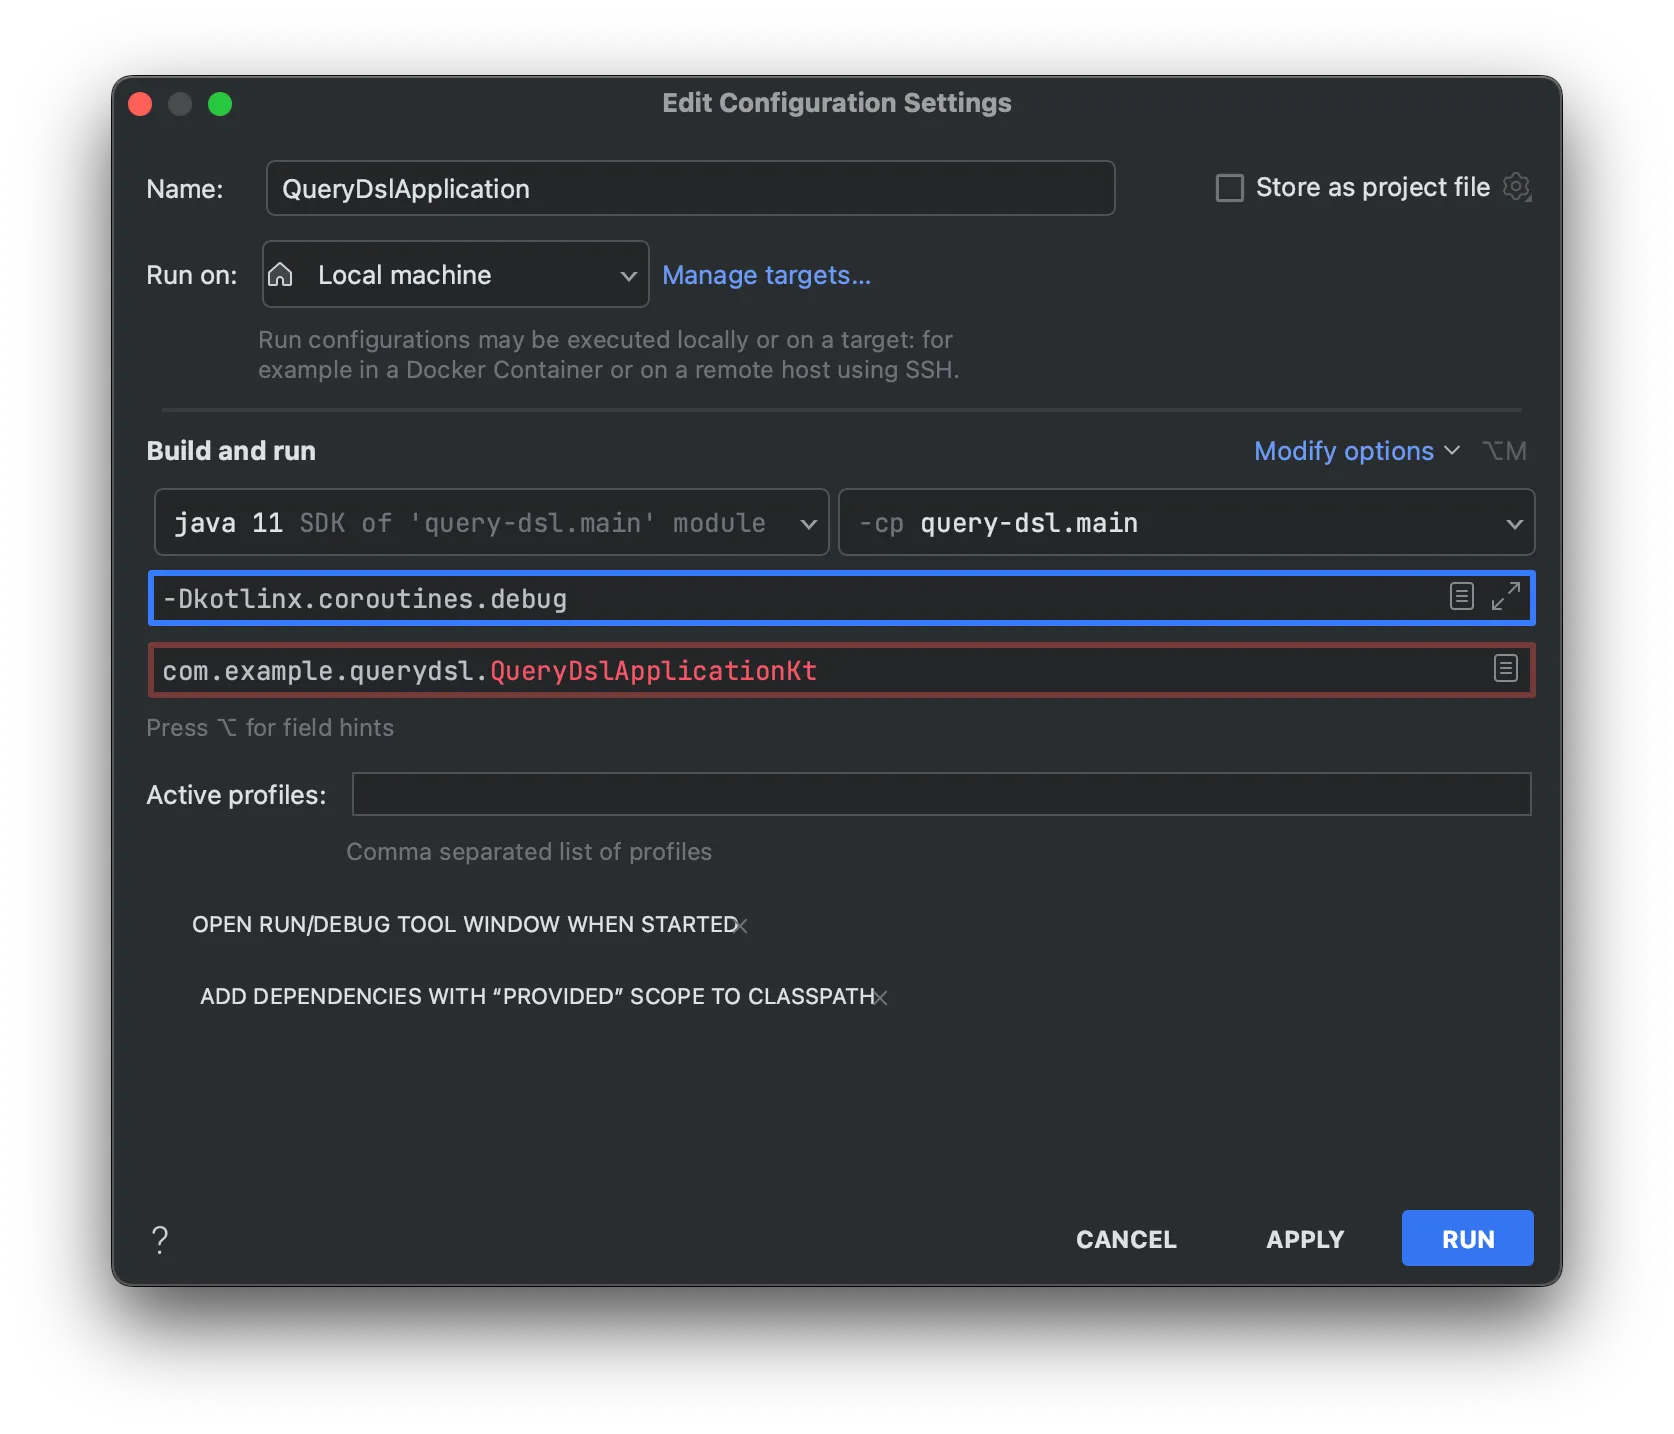
VM 옵션에 -Dkotlinx.coroutines.debug를 추가하면 실행 중인 코루틴이 어떤 스레드에서 도는지 직접 확인할 수 있습니다.
테스트로 검증
Count 쿼리에 1,000ms, Content 쿼리에 500ms의 인위적 지연을 걸어 병렬 처리 효과를 검증합니다. 두 작업이 병렬로 실행되면 전체 소요 시간은 순차 합산(1,500ms)이 아니라 오버헤드를 포함해 약 1,000ms 내외(1,037ms)로 측정됩니다.
@Test
fun `count 1,000ms, content 500ms Thread sleep test`() = runBlocking {
        val time = measureTimeMillis {
            orderRepository.findPaging3By(
                pageable = PageRequest.of(0, 10),
                address = "address"
            )
        }
        println("${time}ms") // 1037ms
}findPaging3By는 내부적으로 두 블로킹 작업(Count 쿼리, Content 쿼리)을 async(Dispatchers.IO)로 별도의 I/O 스레드에서 병렬 실행합니다. 순차 실행이라면 1,000ms + 500ms = 1,500ms가 걸려야 하지만, 병렬 실행 덕분에 전체 소요 시간이 약 1,000ms대로 줄어듭니다. 이 결과는 JDBC처럼 블로킹 I/O를 사용하는 환경에서도 코루틴 기반 병렬 처리가 유효한 동시성 확보 수단이라는 것을 보여줍니다.
반복 걷어내기: Support로 위임
지금까지는 각 Repository 구현체마다 Count·Slice·병렬 처리 로직을 직접 작성했습니다. 이제 이 반복을 걷어내어, 앞서 만든 Querydsl4RepositorySupport에 메서드로 편입하겠습니다.
Support에 페이징 메서드 추가
Slice, Page 등 페이징 처리에서 반복되는 로직을 피하고 편리하게 사용하기 위해, 지금까지 다뤄온 로직을 Support 클래스에 위임합니다. select, selectFrom만 제공하던 기존 Querydsl4RepositorySupport에 applyPagination과 applySlicePagination을 추가합니다.
protected fun <T> applyPagination(
    pageable: Pageable,
    contentQuery: Function<JPAQueryFactory, JPAQuery<T>>,
    countQuery: Function<JPAQueryFactory, JPAQuery<Long>>
): Page<T> = runBlocking {
    val jpaContentQuery = contentQuery.apply(queryFactory)
    val content = async(Dispatchers.IO) { querydsl!!.applyPagination(pageable, jpaContentQuery).fetch() as List<T> }
    val count = async(Dispatchers.IO) { countQuery.apply(queryFactory).fetchFirst() }

    PageImpl(content.await(), pageable, count.await())
}

protected fun <T> applySlicePagination(
    pageable: Pageable,
    query: Function<JPAQueryFactory, JPAQuery<T>>
): Slice<T> {
    val jpaContentQuery = query.apply(queryFactory)
    val content = querydsl!!.applyPagination(pageable, jpaContentQuery)
        .limit((pageable.pageSize + 1).toLong()) // applyPagination이 건 limit을 덮어씀
        .fetch()
    val hasNext = content.size > pageable.pageSize
    return SliceImpl(content.take(pageable.pageSize), pageable, hasNext)
}applyPagination은Pageable과 Content 쿼리(contentQuery), Count 쿼리(countQuery)를 입력받아 앞서 다룬 코루틴 병렬 처리를 그대로 수행합니다.applySlicePagination은 Content 쿼리만 입력받고hasNext판별까지 캡슐화합니다 — 이 구현은 Slice에서 바로잡은+1조회 방식을 반영한 최종 형태입니다.
AS-IS / TO-BE 비교
class OrderCustomRepositoryImpl : Querydsl4RepositorySupport(Order::class.java), OrderCustomRepository {
    // Slice 로직 AS-IS
    override fun findSliceBy(
        pageable: Pageable,
        address: String
    ): Slice<Order> {
        val query: JPAQuery<Order> = from(order).select(order).where(order.address.eq(address))
        val content: List<Order> = querydsl!!.applyPagination(pageable, query).fetch()
        val hasNext: Boolean = content.size >= pageable.pageSize
        return SliceImpl(content, pageable, hasNext)
    }

    // Slice 로직 TO-BE
    override fun findSliceBy2(
        pageable: Pageable,
        address: String
    ): Slice<Order> {
        return applySlicePagination(
            pageable = pageable,
            query = {
                selectFrom(order).where(order.address.eq(address))
            }
        )
    }

    // Page 로직 AS-IS
    override fun findPagingBy(
        pageable: Pageable,
        address: String
    ): Page<Order> = runBlocking {
        val content: Deferred<List<Order>> = async(Dispatchers.IO) {
            from(order)
                .select(order)
                .innerJoin(user).on(order.userId.eq(user.id))
                .leftJoin(coupon).on(order.couponId.eq(coupon.id))
                .where(order.address.eq(address))
                .run {
                    querydsl!!.applyPagination(pageable, this).fetch()
                }
        }
        val totalCount: Deferred<Long> = async(Dispatchers.IO) {
            from(order)
                .select(order.count())
                .where(order.address.eq(address))
                .fetchFirst()
        }

        PageImpl(content.await(), pageable, totalCount.await())
    }

    // Page 로직 TO-BE
    override fun findPaging1(
        pageable: Pageable
    ): Page<Order> {
        return applyPagination(
            pageable = pageable,
            contentQuery = { selectFrom(order).where(order.userId.isNotNull) },
            countQuery = { select(order.count()).from(order).where(order.userId.isNotNull) },
        )
    }

}Querydsl4RepositorySupport를 상속받는 것만으로 applyPagination과 applySlicePagination을 바로 사용할 수 있습니다. 페이징 로직의 반복 구현은 모두 Support 클래스로 위임되고, 각 Repository는 조회 쿼리만 작성하면 되는 구조로 코드가 한결 간결해졌습니다.
여기까지 오면서 Count 쿼리로 인한 병목은 Slice로 걷어내거나 코루틴으로 병렬 처리해 완화했습니다. 그런데 두 해법 모두 여전히 limit, offset을 사용합니다. offset 기반 조회에는 아직 손대지 않은 근본적인 한계가 남아 있습니다.
그래도 남는 한계: offset
offset은 커질수록 느려진다
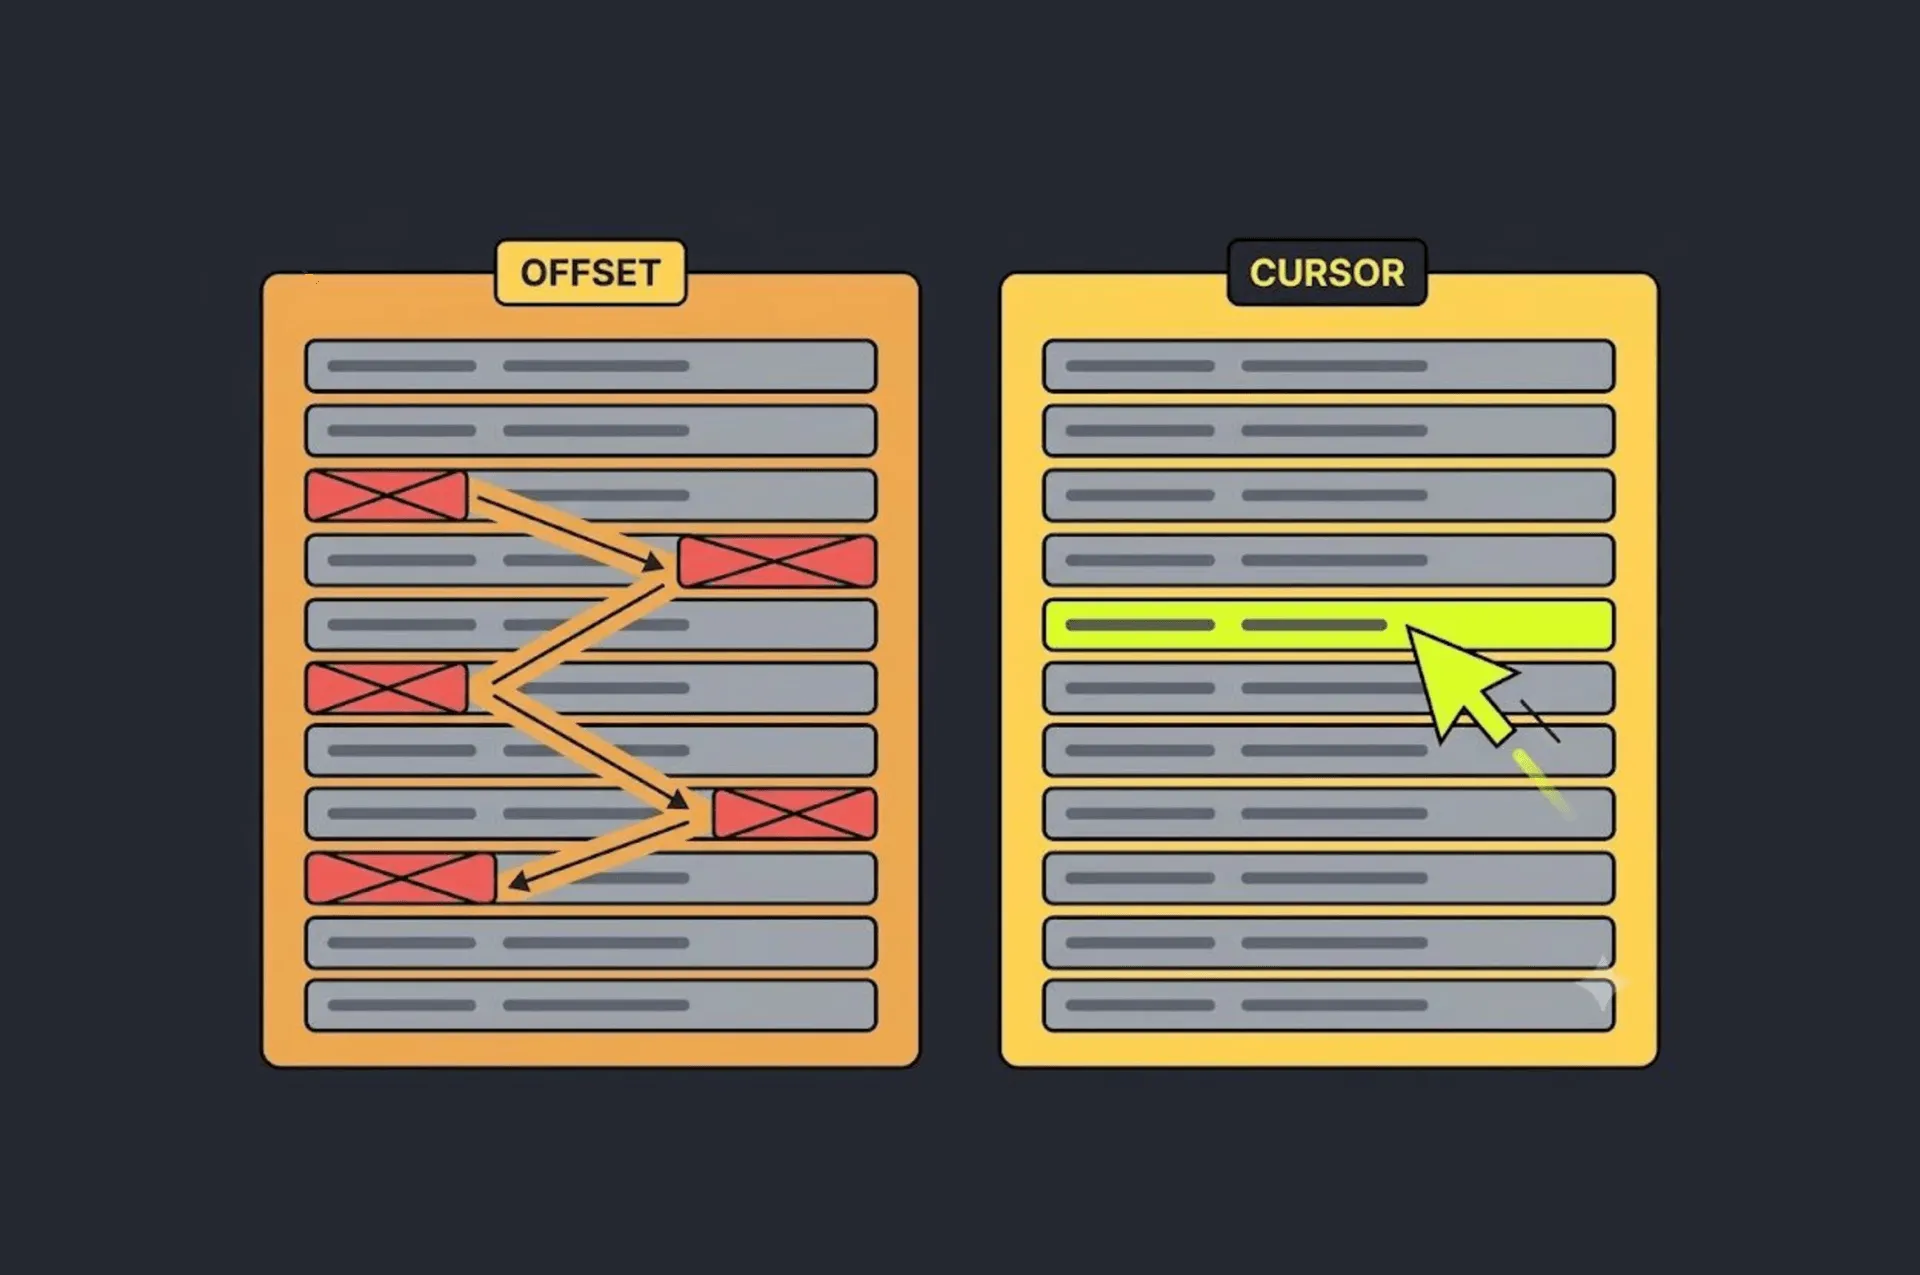
두 방식 모두 limit, offset 기반이라는 공통점이 있습니다. offset이 커질수록 조회 성능이 선형적으로 저하됩니다.
보다 자세한 내용은 [if kakao 2022] Batch Performance를 고려한 최선의 Reader을 참고해 주세요.
JpaPagingItemReader(offset 방식)와 QueryDslNoOffsetPagingReader(No Offset 방식)의 실측 성능을 비교하면 offset의 한계가 명확하게 드러납니다.
| rows | JpaPagingItemReader 소요 시간 (ms) | QueryDslNoOffsetPagingReader 소요 시간 (ms) |
|---|---|---|
| 10,000 | 778 | 658 |
| 100,000 | 8,912 | 3,523 |
| 500,000 | 205,469 | 15,501 |
| 1,000,000 | 1,048,979 | 28,732 |
JpaPagingItemReader 기준으로 10만 건과 50만 건의 차이는 단순히 5배가 아니라 23배 이상입니다. 반면 QueryDslNoOffsetPagingReader는 rows가 늘어나도 선형에 가까운 증가를 보입니다. 실제 수치를 보면 데이터 10배(1만 → 10만) 증가 시 소요 시간은 658ms → 3,523ms, 약 5.4배 증가에 그칩니다. 순수 선형(10배)보다는 살짝 가파르지만, JpaPagingItemReader가 같은 구간에서 23배 이상 증가한 것과 비교하면 증가율이 크게 완만하게 유지된다는 점이 핵심입니다.
그래프에서 JpaPagingItemReader(파란색)의 수치가 워낙 커서 QueryDslNoOffsetPagingReader(빨간색)의 선이 거의 보이지 않을 정도입니다. JpaPagingItemReader를 제외하고 두 리더만 비교해보면 QueryDslNoOffsetPagingReader가 얼마나 안정적인지 알 수 있습니다.
원인을 실행 계획으로 확인해보겠습니다.
실행 계획으로 확인
앞선 성능 측정은 최대 100만 건 모수에서 직접 측정한 결과입니다. 실행 계획은 두 리더 간 격차가 더 극적으로 벌어지는 지점을 살펴보기 위해, 테이블을 500만 건까지 채운 별도의 데이터셋에서 확인했습니다. 데이터 doubling 방식으로 초기 1행 삽입 후 INSERT ... SELECT를 반복해 2^22 = 4,194,304건까지 만들고, doubling만으로 500만 건에 정확히 맞출 수는 없기 때문에 마지막 반복 구간에서 필요한 만큼(약 80만 건)만 잘라서 추가로 삽입하는 방식으로 채웠습니다.
JpaPagingItemReader - 첫 번째 청크 (offset 0)
SELECT *
FROM payment
WHERE created_at >= ?
ORDER BY created_at DESC
LIMIT 1000;| type | key | Extra |
|---|---|---|
| range | IDX_created_at | Using index condition |
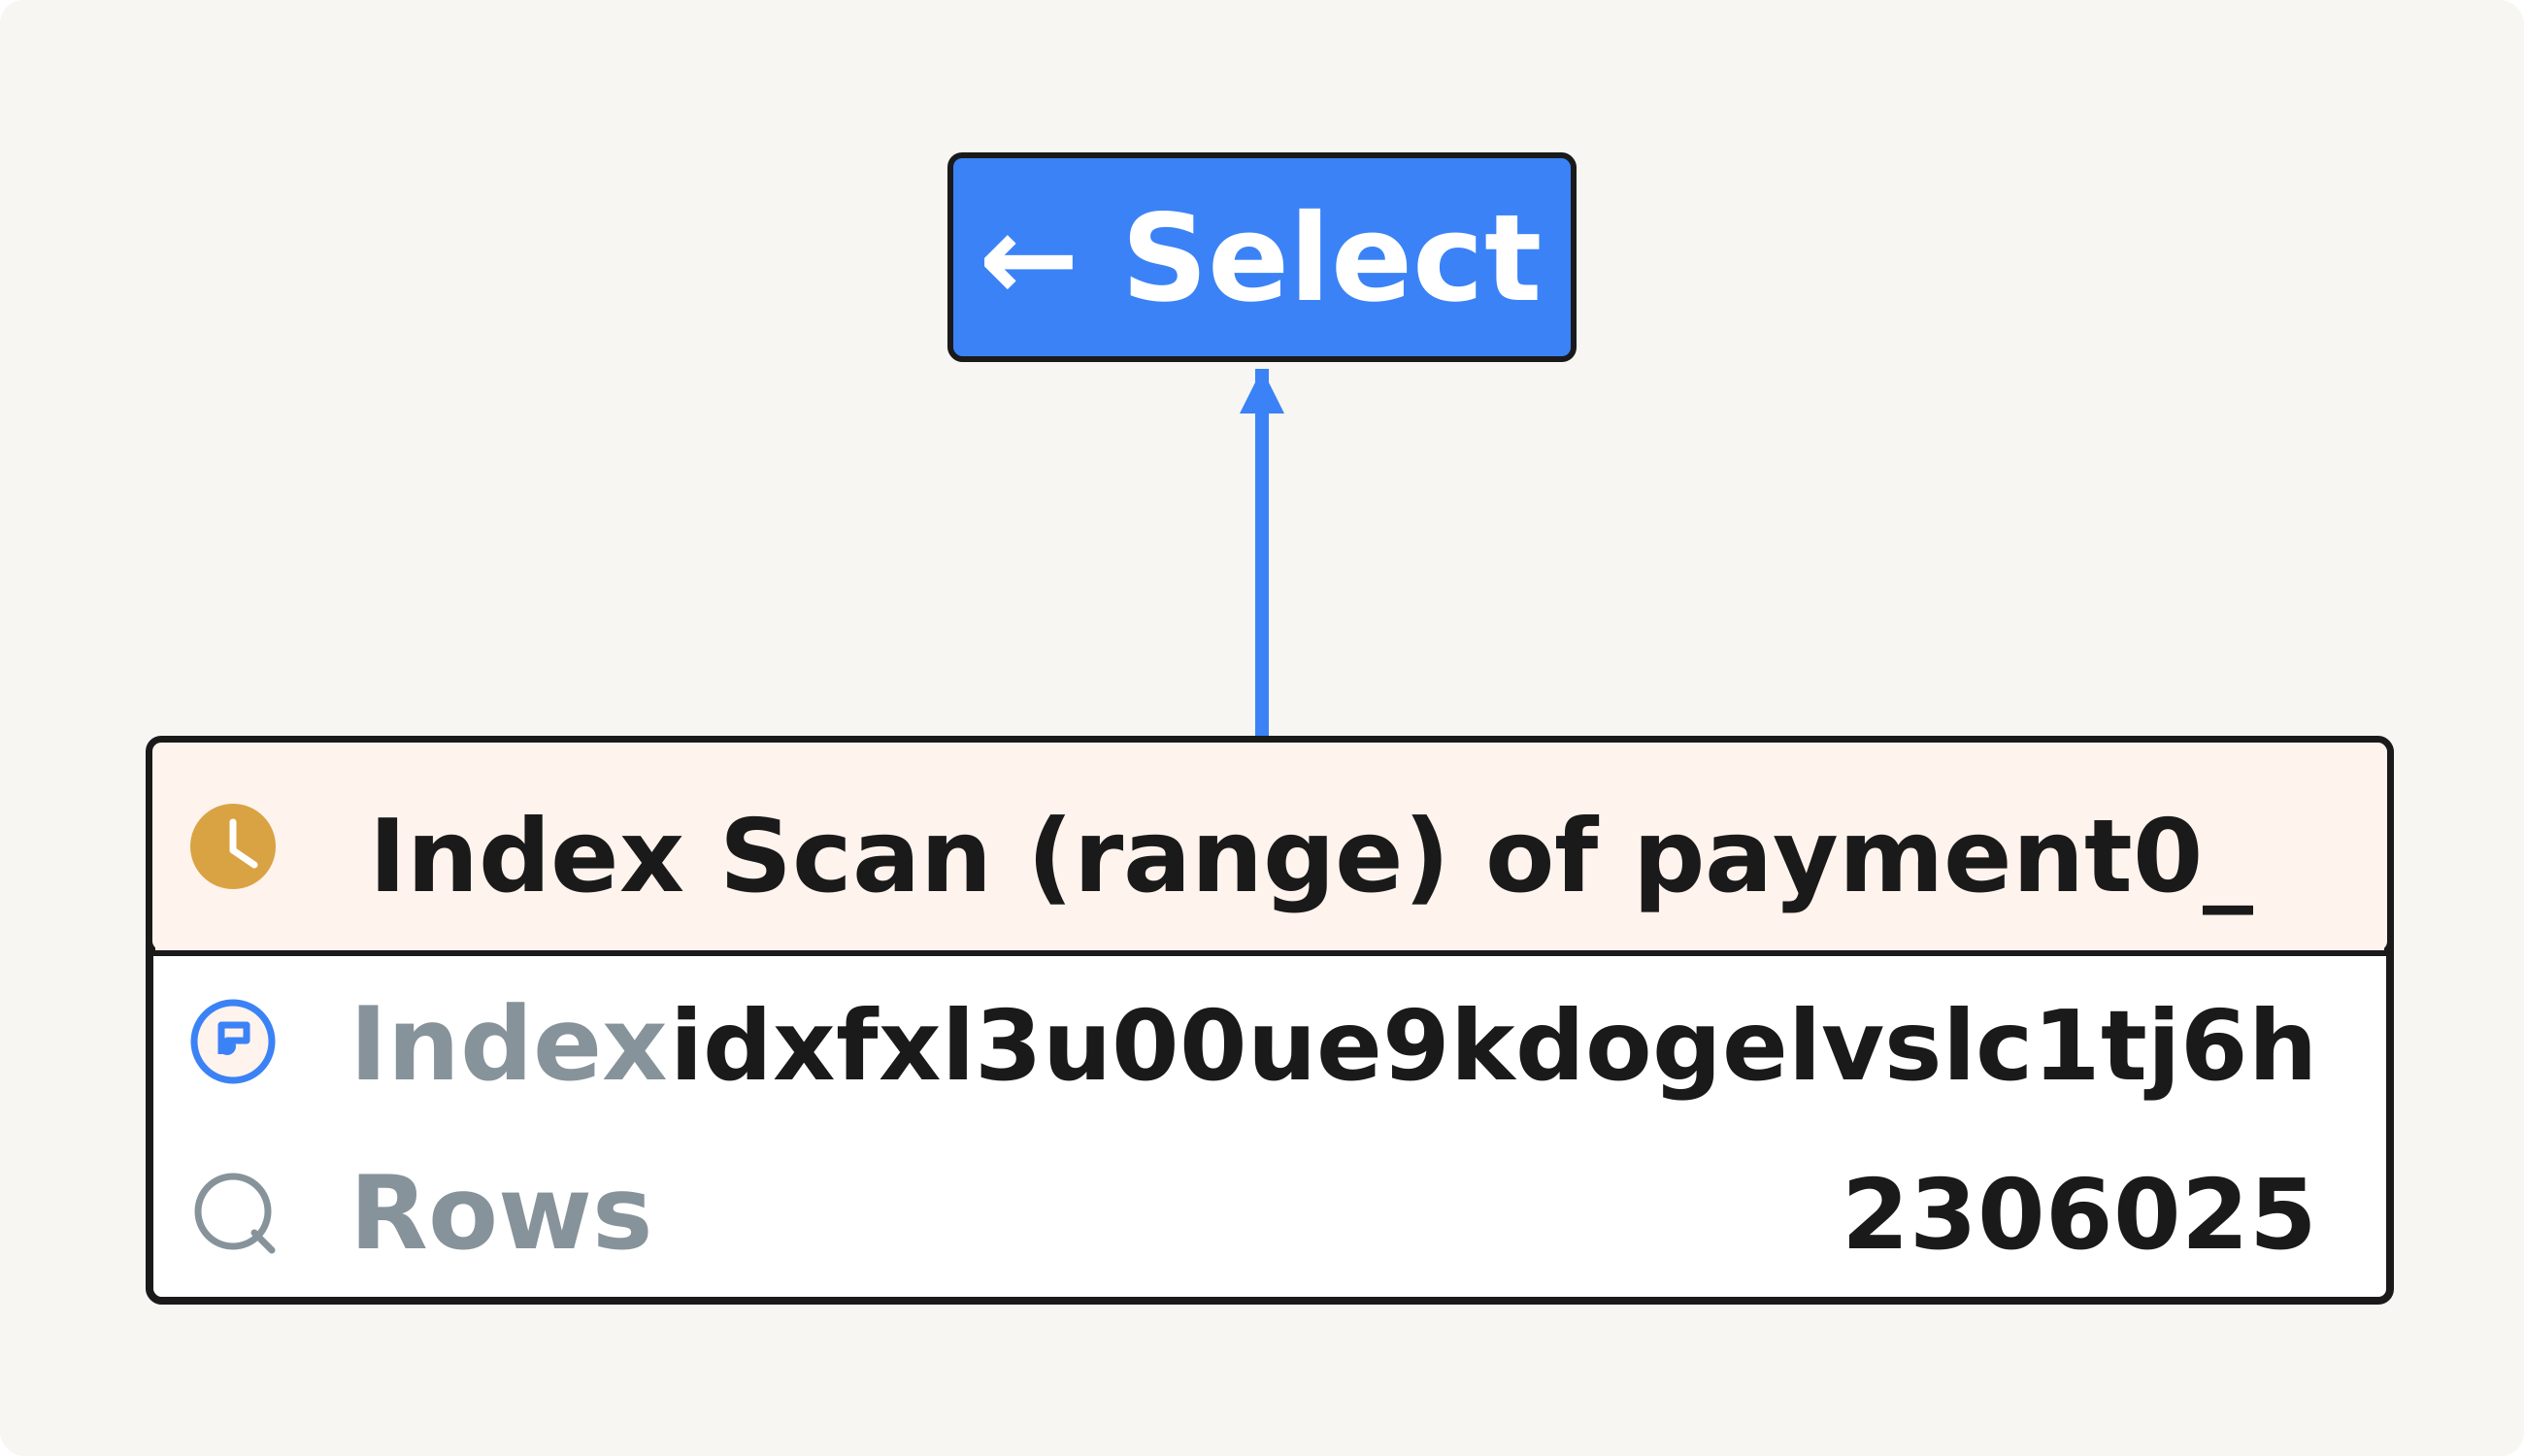
type: range로 인덱스가 정상적으로 동작합니다.
JpaPagingItemReader - 마지막 청크 (offset 4,999,000)
SELECT *
FROM payment
WHERE created_at >= ?
ORDER BY created_at DESC
LIMIT 4999000, 1000;| type | key | Extra |
|---|---|---|
| ALL | NULL | Using where; Using filesort |
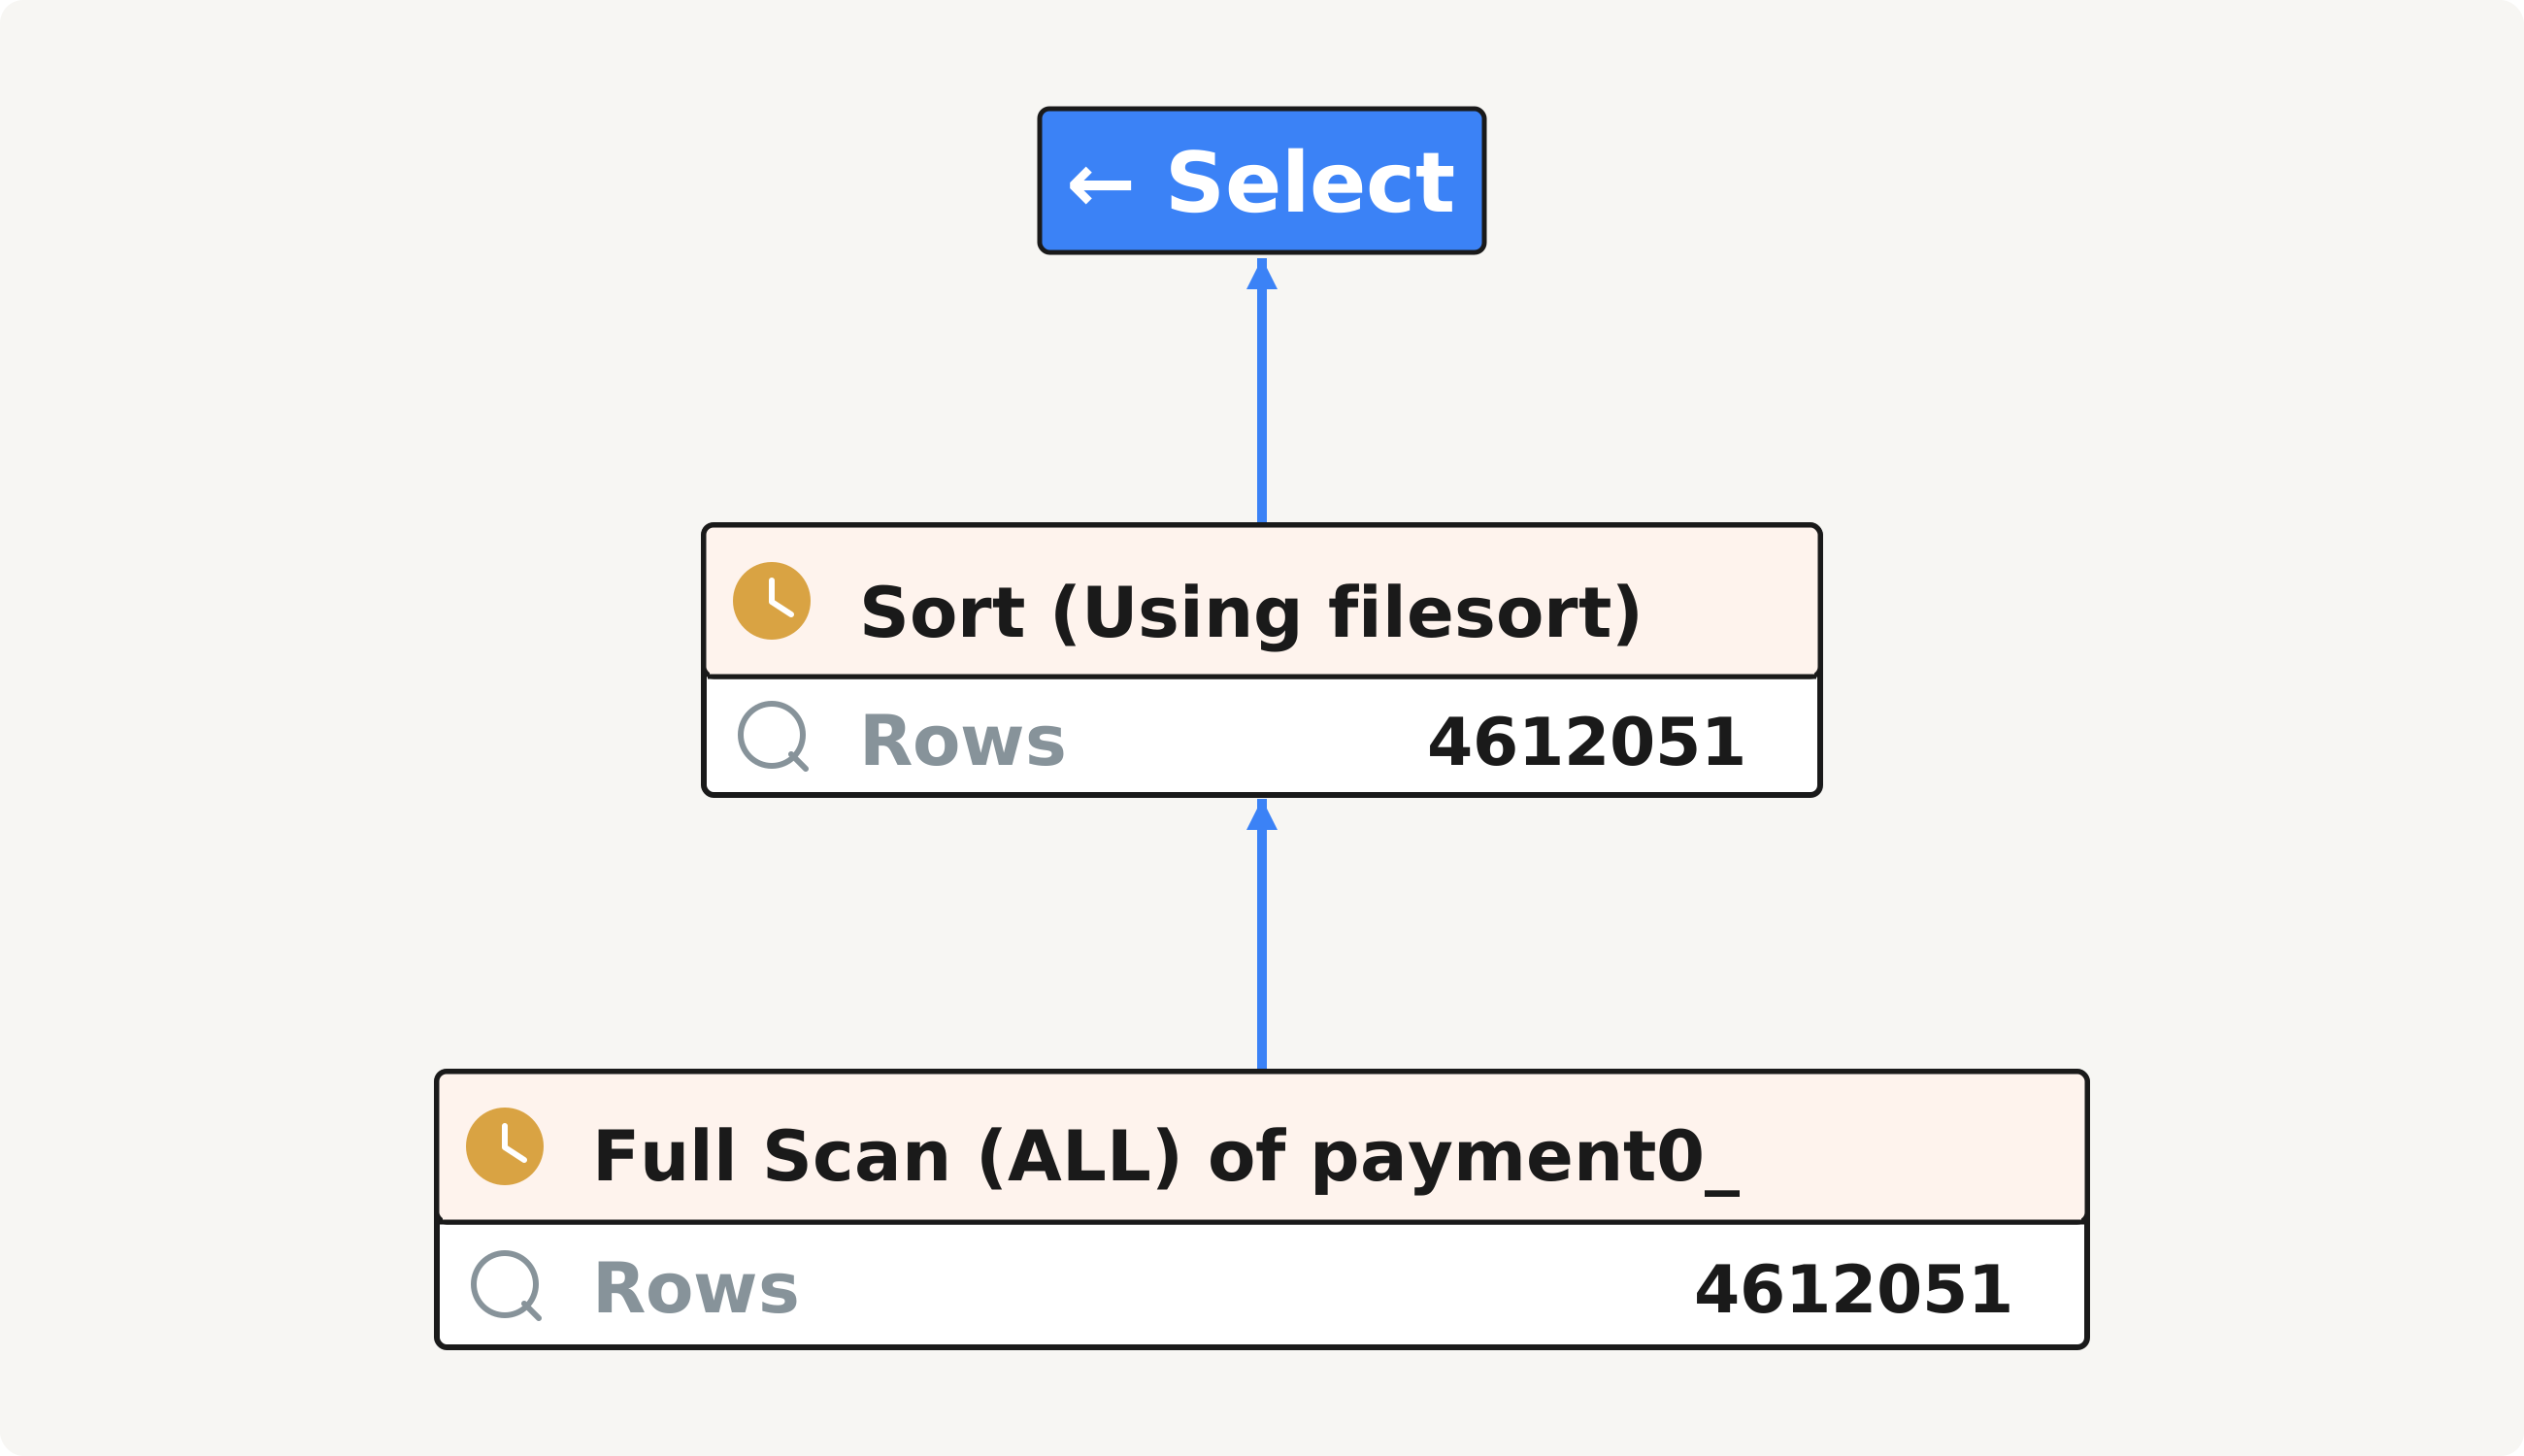
type: ALL, 즉 풀 테이블 스캔이 발생합니다. 인덱스도 사용하지 않습니다.
왜 풀 스캔이 발생하는가
offset의 본질적인 문제를 이해하려면 DB가 offset을 처리하는 방식을 알아야 합니다. LIMIT 4999000, 1000은 “4,999,000번째 행부터 1,000건을 가져와라”라는 의미인데, 데이터베이스는 4,999,000번째 행이 어디 있는지 바로 알 수 없습니다. 버스에서 10번째 줄에 누가 앉아 있는지 확인하려면 앞에서부터 9줄을 직접 세어 가며 확인해야 하는 것처럼, offset도 그 위치까지 도달하려면 앞의 데이터를 모두 읽고 버려야 합니다.
즉 LIMIT 4999000, 1000 쿼리는 4,999,000건을 읽고 전부 버린 뒤, 그다음 1,000건만 돌려주는 동작을 합니다. 실제로 반환되는 데이터는 1,000건이지만 내부적으로는 500만 건 가까운 데이터를 스캔하는 셈입니다.
여기서 옵티마이저의 비용 판단이 개입합니다. 인덱스를 통해 레코드 1건을 읽는 것은 테이블에서 직접 1건을 읽는 것보다 4~5배 비용이 듭니다. 데이터 모수가 적을 때는 인덱스를 타는 편이 훨씬 효율적이지만, 읽어야 할 범위가 테이블 전체의 20~25%를 넘어서면 옵티마이저는 인덱스로 한 건씩 찾아가는 것보다 테이블을 통째로 풀 스캔하는 편이 낫다고 판단합니다. 두 수치(4~5배, 20~25%)는 커버링 인덱스 여부나 범위 조건의 분포에 따라 달라질 수 있는 통용되는 경험값 정도로 이해하는 것이 좋습니다. 그 결과 후반 청크에서는 인덱스가 사라지고 풀 스캔이 선택됩니다.
No Offset은 왜 일정한가
No Offset 방식은 offset 없이 마지막으로 읽은 위치를 커서로 삼는 방식입니다. WHERE id > 직전 청크의 마지막 id 조건으로 다음 데이터를 찾습니다.
-- 첫 번째 청크
SELECT *
FROM payment
WHERE created_at >= ?
  AND id >= 1
  AND id <= 1000
ORDER BY id ASC
LIMIT 1000;

-- 마지막 청크
SELECT *
FROM payment
WHERE created_at >= ?
  AND id >= 4999001
  AND id <= 5000000
ORDER BY id ASC
LIMIT 1000;| type | key | Extra |
|---|---|---|
| range | PRIMARY | Using where |
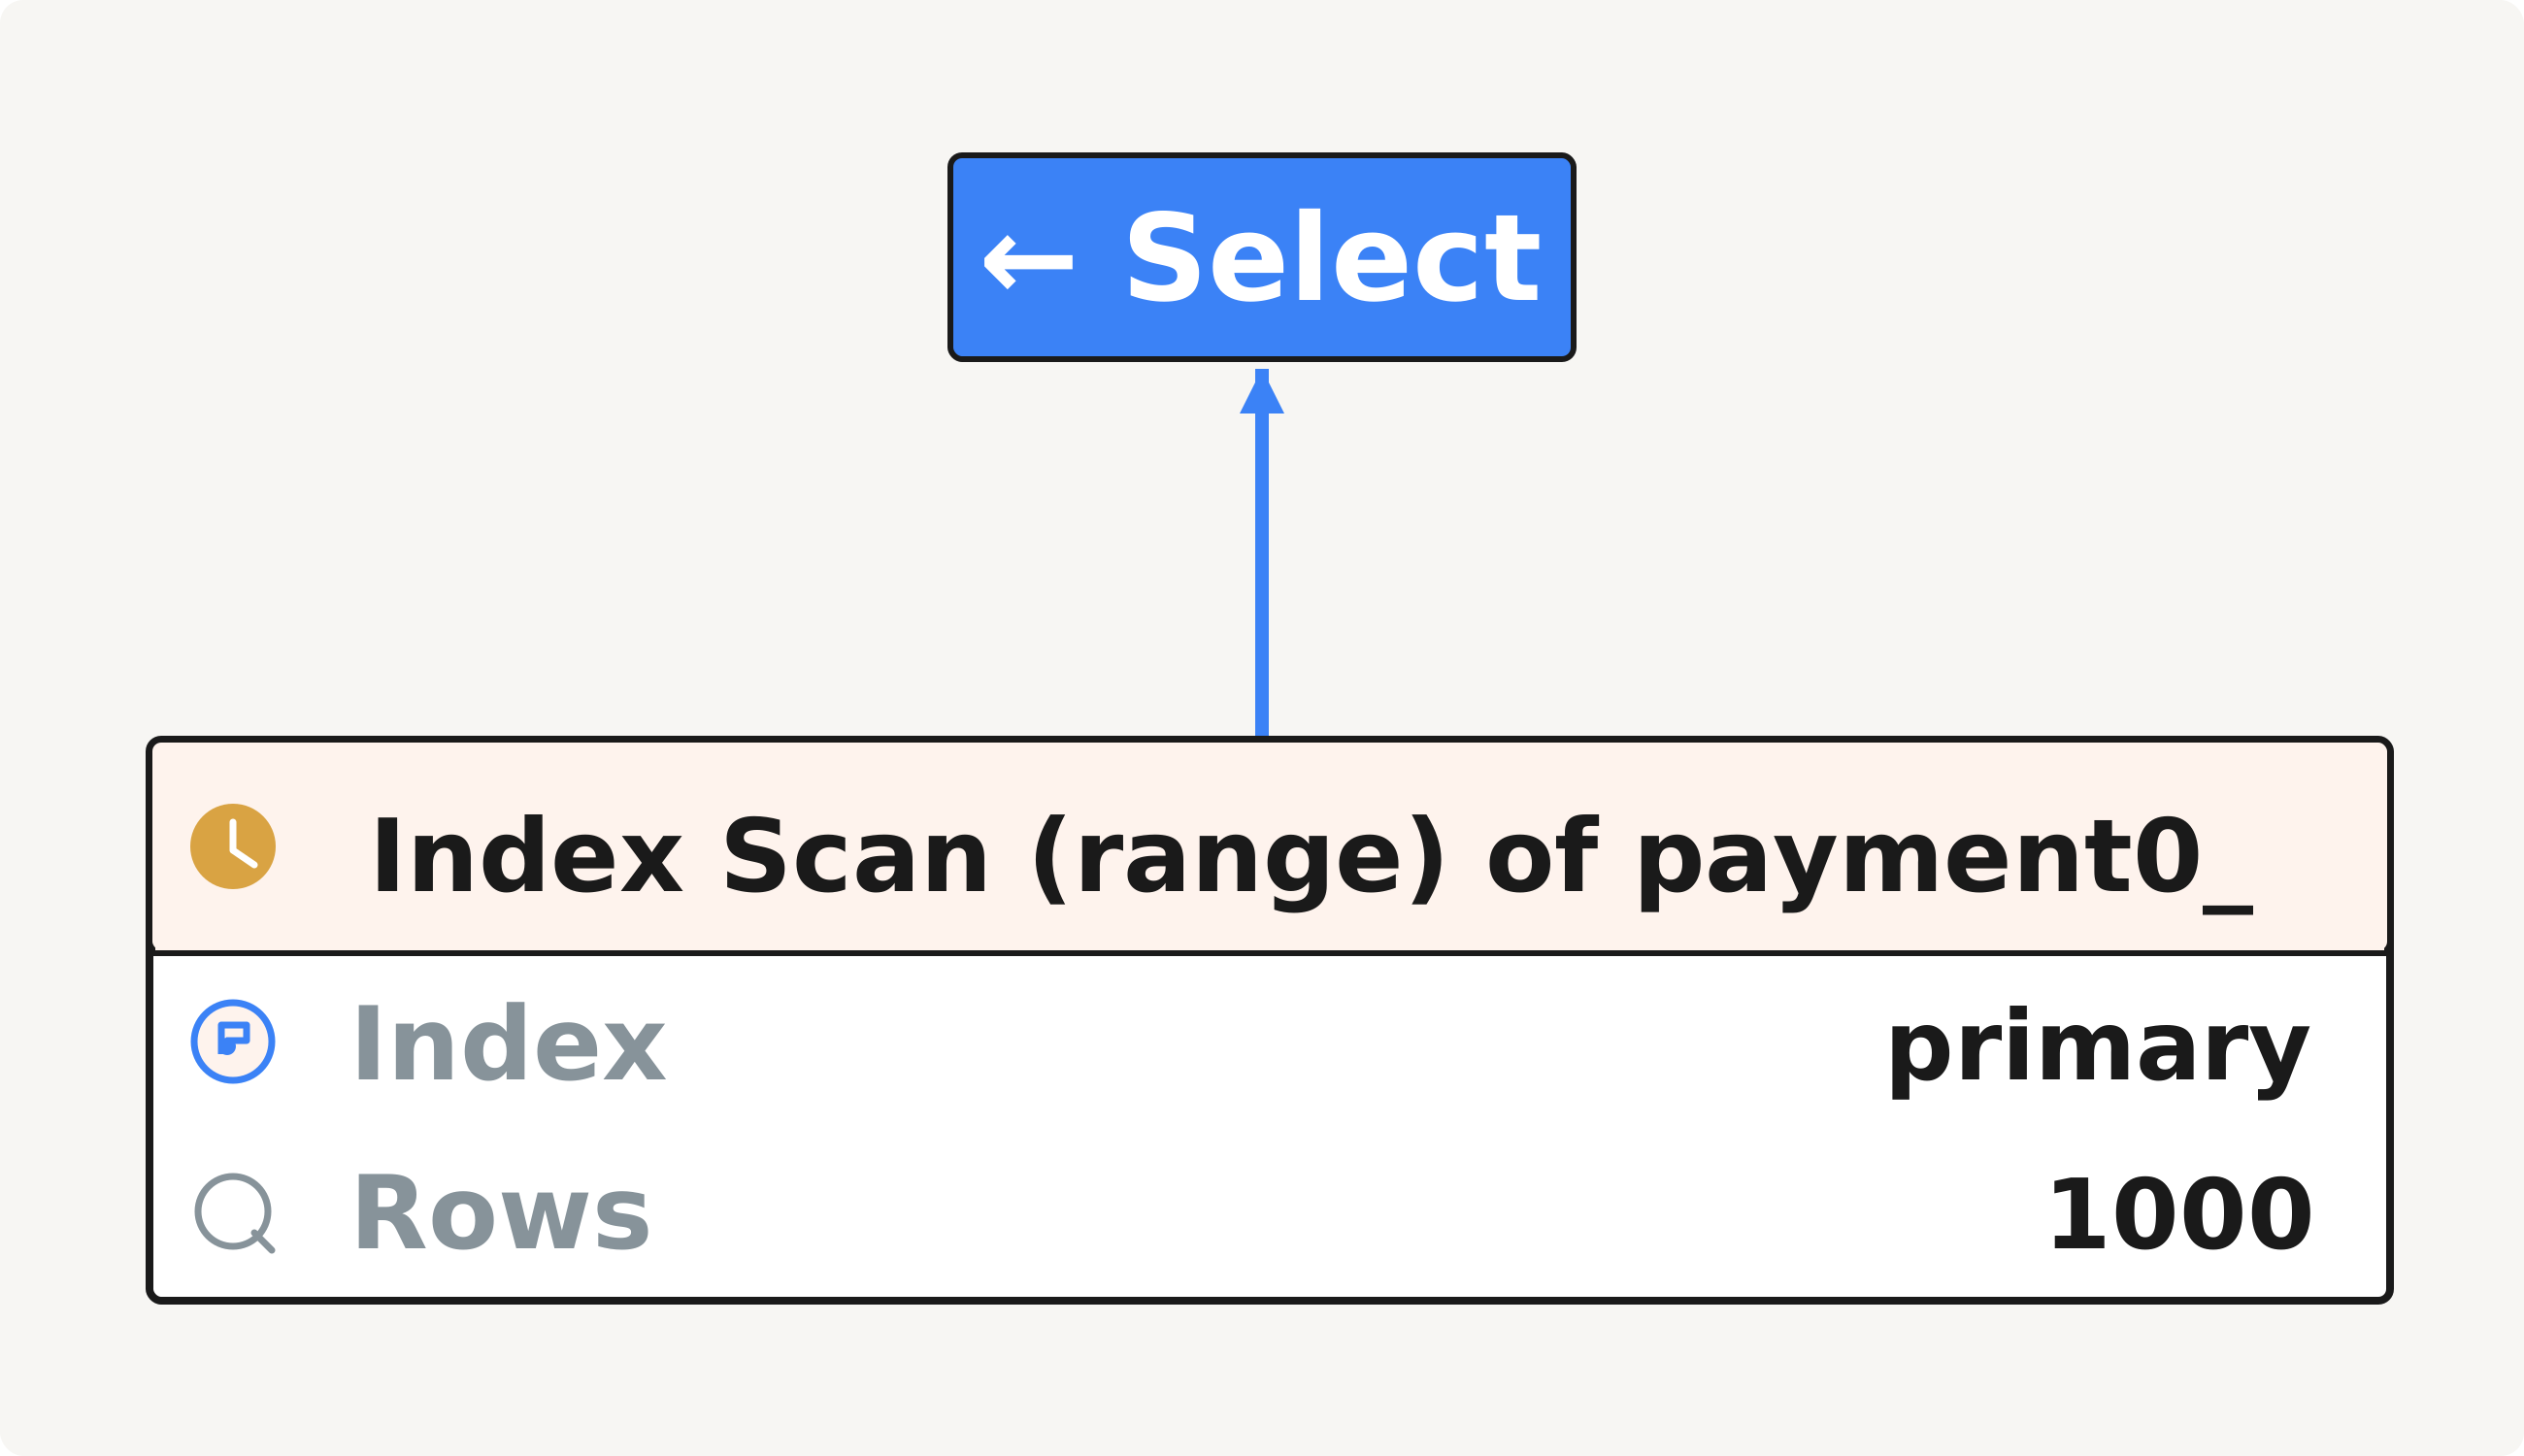
첫 번째 청크와 마지막 청크의 실행 계획이 동일합니다. PK 인덱스(PRIMARY)를 기준으로 범위 조회하기 때문에, offset이 누적되어도 스캔 비용이 일정하게 유지됩니다.
정리하면, offset/limit 방식은 offset이 커질수록 그 위치까지 도달하기 위한 스캔 비용이 누적되어 결국 풀 스캔으로 전환되는 구조적 한계를 가집니다. No Offset 방식은 이 문제를 커서 조건으로 원천 차단합니다.
커서 기반 페이지네이션
배치 Reader와 API 탐색은 요구가 다르다
앞서 살펴본 QueryDslNoOffsetPagingReader도 커서 기반 발상을 활용하지만, 그 용도는 배치 Item Reader에 특화되어 있습니다. 데이터를 처음부터 끝까지 한 방향으로 순차 처리하는 것이 목적이기 때문에 “다음 청크”만 지원하면 충분합니다.
반면 REST API로 페이지 탐색 기능을 제공할 때는 요구사항이 다릅니다. 사용자 또는 어드민이 화면에서 다음과 같은 탐색을 요청할 수 있습니다.
- 첫 번째 페이지로 이동 (FIRST)
- 마지막 페이지로 이동 (LAST)
- 현재 페이지에서 다음 페이지로 (NEXT)
- 현재 페이지에서 이전 페이지로 (PREV)
applyCursorPagination은 이 네 가지 방향을 모두 지원하는 양방향 커서 탐색 API를 제공하기 위해 설계되었습니다.
커서란 무엇인가
커서 기반 페이지네이션의 핵심 아이디어는 offset을 없애는 것입니다. offset 대신 마지막으로 조회한 데이터의 ID를 커서(cursor)로 삼아 WHERE id < :cursor 조건으로 다음 데이터를 가져오는 방식입니다.
-- offset 방식 (뒤로 갈수록 느려짐)
SELECT *
FROM payment
ORDER BY id DESC
LIMIT 10 OFFSET 4990;

-- cursor 방식 (항상 동일한 실행 계획)
SELECT *
FROM payment
WHERE id < :lastId
ORDER BY id DESC
LIMIT 10;
WHERE id < :lastId는 PK 인덱스를 그대로 활용하기 때문에, 조회 위치가 어디든 실행 계획이 동일하게 유지됩니다.
클라이언트는 응답에 담긴 커서 정보를 다음 요청의 cursorKey(문자열)로 전달하는 방식으로 탐색을 이어갑니다. 서버는 커서 값과 방향(direction)만으로 다음 조회 범위를 결정하기 때문에, 전체 데이터 크기나 현재 페이지 번호를 유지할 필요가 없습니다. 응답의 커서가 정확히 어떤 값을 담는지는 다음 절에서 살펴봅니다.
동작 원리
데이터가 8건(id: 1~8)이고 pageSize=2인 경우를 예로 들겠습니다.
전체 데이터: [8, 7, 6, 5, 4, 3, 2, 1] (id, DESC 기준)FIRST - 첫 페이지 (커서 없음):
SELECT *
FROM payment
ORDER BY id DESC
LIMIT 3;
-- pageSize + 1
-- 결과: [8, 7, 6]actualContent: [8, 7] (pageSize만큼 자름)hasNext: true (3건 > pageSize 2)nextCursor: id=7인 Payment 엔티티 (마지막 항목)hasPrev: falseprevCursor: null
NEXT (cursorKey=“7”):
SELECT *
FROM payment
WHERE id < 7
ORDER BY id DESC
LIMIT 3;
-- 결과: [6, 5, 4]actualContent: [6, 5]hasNext: truenextCursor: id=5인 Payment 엔티티prevCursor: id=6인 Payment 엔티티hasPrev: true
NEXT (cursorKey=“3”) - 마지막 페이지:
SELECT *
FROM payment
WHERE id < 3
ORDER BY id DESC
LIMIT 3;
-- 결과: [2, 1]actualContent: [2, 1]hasNext: false (2건 ≤ pageSize 2)nextCursor: nullhasPrev: trueprevCursor: id=2인 Payment 엔티티
여기서 짚어야 할 것이 하나 있습니다. nextCursor는 Payment 엔티티(T?) 그 자체이지만, 다음 요청의 CursorRequest.cursorKey는 문자열(String?)입니다. 즉 클라이언트가 응답으로 받은 nextCursor를 그대로 다음 요청에 실어 보낼 수는 없습니다. API 응답을 만드는 계층에서 nextCursor 엔티티로부터 id 값을 꺼내 문자열로 변환한 뒤, 클라이언트가 그 문자열을 다음 요청의 cursorKey로 전달하도록 별도로 감싸주어야 합니다.
이 +1 조회로 hasNext/hasPrev를 판별하는 방식은 Slice에서 이미 다룬 바로 그 기법입니다. 커서 기반 조회에서도 동일한 원리가 그대로 재사용됩니다.
구현
fun <T> applyCursorPagination(
    cursorRequest: CursorRequest,
    cursorPath: NumberPath<Long>,
    contentQuery: Function<JPAQueryFactory, JPAQuery<T>>,
): CursorPageResponse<T> {
    val direction = cursorRequest.direction
    val pageSize = cursorRequest.pageSize
    val cursorValue = cursorRequest.cursorKey?.toLong()

    val query = contentQuery.apply(queryFactory)

    when (direction) {
        CursorDirection.FIRST, CursorDirection.LAST -> Unit
        CursorDirection.NEXT -> {
            requireNotNull(cursorValue) { "Cursor key must be provided for NEXT direction" }
            query.where(cursorPath.lt(cursorValue))
        }
        CursorDirection.PREV -> {
            requireNotNull(cursorValue) { "Cursor key must be provided for PREV direction" }
            query.where(cursorPath.gt(cursorValue))
        }
    }

    query.orderBy(
        when {
            direction.isForward -> cursorPath.desc()
            else -> cursorPath.asc()
        }
    )
    query.limit((pageSize + 1).toLong())
    val content = query.fetch()
    return CursorPageResponse(
        content = content,
        direction = direction,
        pageSize = pageSize,
    )
}contentQuery에는 기본 조회 쿼리만 전달하면 됩니다. WHERE 커서 조건, ORDER BY, LIMIT 처리는 applyCursorPagination이 담당합니다.
실제 Repository에서는 다음과 같이 사용합니다.
fun findByCursor(cursorRequest: CursorRequest): CursorPageResponse<Payment> {
    return applyCursorPagination(
        cursorRequest = cursorRequest,
        cursorPath = qPayment.id,
        contentQuery = { selectFrom(qPayment) }
    )
}
CursorPageResponse
응답 객체는 팩토리 함수(invoke)를 통해 방향별 커서와 플래그를 자동으로 계산합니다.
data class CursorPageResponse<T> private constructor(
    val content: List<T>,
    val hasNext: Boolean,
    val hasPrev: Boolean,
    val nextCursor: T?,
    val prevCursor: T?,
)| direction | content | hasNext | hasPrev | nextCursor | prevCursor |
|---|---|---|---|---|---|
| FIRST | take(pageSize) | 초과 여부 | false | 마지막 항목 or null | null |
| NEXT | take(pageSize) | 초과 여부 | true | 마지막 항목 or null | 첫 번째 항목 |
| PREV | take(pageSize).reversed() | true | 초과 여부 | 마지막 항목 | 첫 번째 항목 or null |
| LAST | take(pageSize).reversed() | false | 초과 여부 | null | 첫 번째 항목 or null |
backward(PREV/LAST) 방향은 DB에서 ASC로 조회한 결과를 reversed()로 뒤집어 표시 순서를 맞춥니다.
한 가지 유의할 점이 있습니다. LAST는 커서 방식이 “마지막 페이지로 이동”이라는 완전한 기능이 아니라 근사치라는 점입니다. 커서는 이전 페이지 결과에서 연속적으로 이어지는 구조이기 때문에, 커서 없이 데이터의 끝 위치를 특정할 방법이 없습니다. 그래서 LAST 구현은 ASC 조회 후 뒤집는 방식으로 “마지막 페이지에 가까운 결과”를 내려주는데, 전체 건수가 pageSize로 나누어떨어지지 않으면(총 건수 % pageSize ≠ 0) 페이지 경계(청크 경계)가 (총 건수 % pageSize)만큼 어긋난 페이지가 반환될 수 있습니다. 정확한 마지막 페이지가 필요하다면 데이터 끝 지점을 커서로 전달해 NEXT로 접근하는 것이 안전합니다.
지금까지 구현한 커서 방식이 실제로 offset 방식보다 얼마나 빠른지, 직접 측정해서 확인해보겠습니다.
검증: limit/offset vs cursor
100만 건 데이터 셋업
성능 측정을 위해 payment 테이블에 100만 건 데이터를 셋업합니다. Doubling 방식(INSERT INTO … SELECT)으로 기준 1행을 삽입한 뒤 위 INSERT를 20번 반복하면 매 실행마다 테이블 전체가 복제되어 행 수가 2^n으로 증가하므로, 최초 1행 포함 총 2^20 = 1,048,576건을 빠르게 생성할 수 있습니다.
-- 1. 기존 데이터 초기화
TRUNCATE TABLE payment;

-- 2. 기준 1행 삽입
INSERT INTO payment (amount, created_at, updated_at)
VALUES (500.00, '2023-01-01 00:00:00', NOW());

-- 3. 아래 INSERT를 20번 반복 실행 (기준 1행이 함께 복제되어 매 실행마다 행 수 2배 증가)
-- 1회: 2건 / 5회: 32건 / 10회: 1,024건 / 15회: 32,768건 / 20회: 1,048,576건 (총 2^20 건)
INSERT INTO payment (amount, created_at, updated_at)
SELECT ROUND(RAND() * 1000, 2),
       DATE_ADD('2023-01-01 00:00:00', INTERVAL FLOOR(RAND() * 730 * 24 * 3600) SECOND),
       NOW()
FROM payment;

-- 4. 검증
SELECT COUNT(*)
FROM payment;

SELECT DATE_FORMAT(created_at, '%Y-%m') AS month,
       COUNT(*)                         AS cnt
FROM payment
GROUP BY month
ORDER BY month;
limit/offset과 커서 쿼리 비교
데이터 셋업(1,048,576건, created_at 2023~2024년 분산)을 기준으로 limit/offset 방식과 커서 방식의 SQL을 각각 첫 번째·중간·마지막 페이지로 비교합니다. limit size는 100으로 고정합니다. id는 1부터 연속적으로 채번되어 최대 id가 1,048,576이라고 가정합니다.
limit / offset 방식
-- 첫 번째 페이지 (offset 0)
SELECT *
FROM payment
ORDER BY id DESC
LIMIT 100 OFFSET 0;

-- 약 5,241 페이지 (offset ~524,000, 전체의 약 50% 지점)
SELECT *
FROM payment
ORDER BY id DESC
LIMIT 100 OFFSET 524000;

-- 약 8,241 페이지 (offset ~824,000, 전체의 약 79% 지점)
SELECT *
FROM payment
ORDER BY id DESC
LIMIT 100 OFFSET 824000;

-- 마지막 페이지 (offset ~1,048,476, 전체 끝 지점)
SELECT *
FROM payment
ORDER BY id DESC
LIMIT 100 OFFSET 1048476;
커서 방식
-- 첫 번째 페이지 (커서 없음, id 최댓값 1,048,576부터 시작)
SELECT *
FROM payment
ORDER BY id DESC
LIMIT 100;

-- 약 50% 지점 (id 약 524,576 기준, 1,048,576 - 524,000)
SELECT *
FROM payment
WHERE id < 524576
ORDER BY id DESC
LIMIT 100;

-- 약 79% 지점 (id 약 224,576 기준, 1,048,576 - 824,000)
SELECT *
FROM payment
WHERE id < 224577
ORDER BY id DESC
LIMIT 100;

-- 마지막 페이지 (id 약 101 기준, 끝 지점)
SELECT *
FROM payment
WHERE id < 101
ORDER BY id DESC
LIMIT 100;
측정 결과
테스트 환경: 애플리케이션과 MySQL을 동일한 로컬 환경(loopback)에서 연결한 상태로 측정한 결과입니다(Spring Boot 3.2.1, Querydsl 5.1.0, Kotlin 1.9.21, JDK 17 기준).
측정 환경(하드웨어, MySQL 버전, 동시 부하 등)에 따라 절대적인 ms 수치는 달라질 수 있습니다. 그래서 여기서는 절대값 대신, 각 방식의 첫 번째 페이지 소요 시간을 기준(1.0배)으로 놓고 나머지 구간이 얼마나 늘어나는지 상대 배수로 환산해 비교합니다.
| 구간 | limit/offset | cursor |
|---|---|---|
| 첫 번째 | 1.0배 (기준) | 1.0배 (기준) |
| 약 50% 지점 | 2.0배 | 1.0배 |
| 약 79% 지점 | 2.7배 | 1.0배 |
| 마지막 | 3.3배 | 1.0배 |
limit/offset 방식은 뒤로 갈수록 격차가 급격히 벌어져, 첫 페이지 대비 마지막 페이지에서 소요 시간이 3.3배로 늘어납니다. 반면 cursor 방식은 조회 위치와 무관하게 항상 1.0배 언저리, 즉 일정한 비용을 유지합니다.
이 차이는 단발성 API 호출에서도 체감되지만, 전체 데이터를 순차적으로 읽어 리포트를 생성하는 배치 처리에서 더욱 치명적입니다. 예를 들어 100만 건의 결제 데이터를 페이지 단위로 모두 읽어 월별 매출 집계를 산출하는 배치를 생각해보면, limit/offset 방식은 청크가 뒤로 넘어갈수록 쿼리 1건당 소요 시간이 계속 누적되어 증가합니다. 반면 cursor 방식은 청크 위치와 무관하게 매 쿼리가 일정한 비용으로 동작하기 때문에 전체 처리 시간이 선형에 가깝게 유지됩니다.
결국 “어느 위치를 조회하든 동일한 실행 계획”이라는 cursor의 특성이, 반복 호출이 누적되는 배치 환경에서 성능 격차를 더욱 크게 만드는 핵심 이유입니다.
커서 기반 페이지네이션은 offset의 한계를 확실하게 해결합니다. 하지만 빠르다고 해서 모든 상황에 적합한 것은 아닙니다. 커서를 적용하기 전에 반드시 확인해야 할 제약과, 애초에 커서가 적합하지 않은 경우를 짚어보겠습니다.
커서의 한계와 선택 기준
contentQuery에 정렬을 넣지 마세요
applyCursorPagination은 내부에서 cursorPath를 기준으로 ORDER BY를 자동으로 추가합니다. contentQuery에 별도의 정렬 조건을 넣으면 충돌이 발생할 수 있습니다.
// Bad - contentQuery에 orderBy 추가
contentQuery = { selectFrom(qPayment).orderBy(qPayment.createdAt.desc()) }

// Good - 기본 조회 쿼리만
contentQuery = { selectFrom(qPayment) }
커서가 적합하지 않은 경우
커서 기반 조회는 ID처럼 순차적이고 유니크한 값을 기준으로 동작합니다. 다음 경우에는 적합하지 않을 수 있습니다.
1. GROUP BY가 포함된 쿼리
GROUP BY 결과에서 ID 기준으로 커서를 잡기 애매합니다. 예를 들어 카테고리별 합계를 조회하는 경우, 집계 결과의 행에는 단일 ID가 존재하지 않아 커서의 연속성이 깨집니다.
-- ID 커서를 적용하기 어려운 쿼리
SELECT category, SUM(amount)
FROM payment
GROUP BY category;
2. ID와 다른 기준으로 정렬하는 경우
커서 기반 조회는 ID의 대소 비교로 페이지를 나눕니다. 정렬 기준이 ID와 다른 경우(예: amount DESC) 커서가 정렬 순서와 일치하지 않아 데이터 누락이나 중복이 발생할 수 있습니다.
3. 임의 페이지 이동이 필요한 경우
“26페이지로 바로 이동” 같은 임의 페이지 이동은 커서 기반으로는 지원하기 어렵습니다. 커서는 이전 페이지의 결과에서 연속적으로 이어지는 구조이기 때문입니다.
정리하면, 커서 기반 조회는 시계열 데이터를 ID 기준으로 순차 탐색하는 패턴에 가장 잘 맞습니다. 피드, 알림 목록, 거래 내역처럼 최신순으로 스크롤하는 화면이 대표적인 적합 사례입니다.
중간 정리: 세 가지 페이징 방식
지금까지 살펴본 세 가지 페이징 방식을 정리하면 다음과 같습니다.
| 방식 | Count 쿼리 | 후반부 성능 저하 | 임의 페이지 이동 | 배치 처리 적합성 | 적합한 화면 |
|---|---|---|---|---|---|
| applyPagination | O (병렬) | offset 증가 시 최대 3.3배 이상 저하 | O | X | 전체 페이지 네비게이션 |
| applySlicePagination | X | offset 증가 시 최대 3.3배 이상 저하 | X | X | 무한 스크롤, 더보기 |
| applyCursorPagination | X | 없음 (위치 무관 일정) | X | O | 피드, 알림, 거래 내역, 배치 |
applyPagination과 applySlicePagination은 offset 기반이므로 뒤로 갈수록 쿼리 비용이 선형 이상으로 증가합니다. 실측 기준으로 첫 페이지 대비 마지막 페이지에서 3.3배 이상 느려졌고, 이 차이는 배치처럼 전체 데이터를 반복 순회하는 환경에서 청크마다 누적되어 전체 처리 시간에 직접적인 영향을 줍니다.
applyCursorPagination은 WHERE id < :cursor 조건으로 PK 인덱스를 직접 활용하기 때문에 조회 위치와 무관하게 실행 계획이 동일하게 유지됩니다. 단건 API뿐 아니라 전체 데이터를 순차적으로 읽어야 하는 배치 리포트에도 적합한 방식입니다.
세 가지 방식 모두 Querydsl4RepositorySupport를 통해 공통 함수로 제공됩니다. 임의 페이지 이동이 필요하면 applyPagination, 다음/이전 탐색만 필요하면 applySlicePagination, 대용량 순차 조회라면 applyCursorPagination을 선택하면 됩니다.
그런데 여기까지의 이야기는 모두 읽기에 관한 것입니다. 배치 작업은 읽기에서 끝나지 않습니다. Slice를 다루며 예로 든 회원 등급 업데이트 배치는 읽어 온 주문 데이터를 근거로 회원 정보를 수정해야 하고, 커서 검증에서 언급한 월별 매출 집계 배치는 집계 결과를 리포트 테이블에 저장해야 합니다. 커서로 아무리 빠르게 읽어도 읽은 데이터를 다시 쓰는 구간이 느리다면, 배치 전체의 병목은 그대로 남습니다. 이제 시선을 조회 쿼리에서 쓰기 쿼리로 옮겨보겠습니다.
쓰기 성능 개선: JPA 대량 처리의 벽
수만 건의 데이터를 한 번에 저장하거나 수정하는 작업을 JPA로 그대로 구현하면, 어느 순간부터 처리 시간이 예상을 한참 벗어나기 시작합니다.
Insert와 Update는 각각 다른 이유로 성능 문제에 부딪힙니다. Insert는 saveAll을 사용할 때 IDENTITY(PK를 DB가 INSERT 이후에 채번하는 식별자 전략) 전략이 JDBC 레벨의 Batch Insert를 막아 버리는 문제가 있습니다. Update는 Dirty Checking(트랜잭션 커밋 시점에 엔티티 변경을 감지해 UPDATE를 자동 생성하는 JPA 기능) 방식이 엔티티 수만큼 개별 UPDATE 쿼리를 만들어내는 문제가 있습니다.
원인은 다르지만 결과는 같습니다. 데이터 건수만큼 쿼리가 반복 전송되고, 데이터 양이 늘어날수록 성능이 급격히 저하됩니다.
구조적으로 보면 앞서 살펴본 offset의 한계와 닮아 있습니다. offset이 커질수록 읽기 비용이 누적되어 결국 풀 스캔에 도달했던 것처럼, 건수만큼 쿼리를 반복 전송하는 쓰기 방식도 데이터 양에 비례해 비용이 쌓이다가 한계에 부딪힙니다. 읽기에서 커서로 조회 구조 자체를 바꿔 문제를 원천 차단했듯, 쓰기에서도 전송 구조 자체를 바꿔야 합니다.
지금부터는 이 두 문제를 Querydsl-SQL의 SQLQueryFactory와 addBatch로 각각 해결합니다. 먼저 두 작업에 공통으로 쓰이는 개념을 정리하고, Batch Insert와 Batch Update를 차례로 적용한 뒤, 각각 실제로 측정한 성능 결과까지 살펴봅니다.
Querydsl-SQL 쓰기 준비
왜 Querydsl-SQL인가
대량의 데이터를 다뤄야 할 때 흔히 떠올리는 대안 중 하나는 Exposed 같은 별도의 SQL 전용 라이브러리를 도입하는 것입니다. 하지만 오직 대량 처리 성능 개선만을 위해 JPA 환경에 새로운 ORM을 도입하고 혼합해서 사용하는 것은 설정의 복잡함과 학습 곡선 측면에서 비효율적일 수 있습니다.
이 글처럼 이미 프로젝트에서 JPA와 Querydsl을 사용하고 있다면, 추가적인 라이브러리 도입 없이 Querydsl-SQL 모듈만으로 Type-Safe하게 대량 처리를 구현할 수 있습니다. Querydsl-SQL은 JPA 엔티티 모델이 아닌 데이터베이스 스키마를 기반으로 쿼리를 작성할 수 있게 해주는 모듈로, JPA가 제공하지 않는 세밀한 SQL 제어(Batch Insert/Update, 특정 벤더 전용 구문 등)가 필요할 때 유용합니다. SQLQueryFactory를 통해 JDBC 레벨의 기능을 Type-Safe하게 사용할 수 있습니다.
Querydsl-SQL을 사용하기 위해 build.gradle.kts에 아래 의존성을 추가합니다.
dependencies {
    // Querydsl JPA (기본 사용)
    implementation("com.querydsl:querydsl-jpa:5.1.0:jakarta")

    // Querydsl SQL (Batch Insert/Update를 위해 필요)
    implementation("com.querydsl:querydsl-sql:5.1.0")
}
핵심 개념: RelationalPathBase와 addBatch()
SQLQueryFactory는 RelationalPath 타입을 요구합니다. 그런데 JPA 엔티티 기반으로 생성되는 QWriter는 EntityPathBase이기 때문에, 테이블 참조로 직접 사용할 수 없습니다. 그래서 RelationalPathBase로 테이블 메타데이터를 별도로 정의해야 합니다. 컬럼 참조 자체는 기존에 생성된 QWriter의 path를 그대로 활용할 수 있습니다.
- RelationalPathBase: SQL 쿼리 작성을 위해 대상 테이블의 메타데이터를 정의합니다.
- QWriter.writer.*: 컬럼 참조에는 기존에 생성된 Q클래스의 path를 그대로 활용합니다.
- addBatch(): 루프를 돌며 데이터를 즉시 실행하지 않고, JDBC의 Batch 기능을 활용하기 위해 메모리에 쿼리 파라미터들을 쌓아둡니다.
- execute(): 쌓여있는 Batch 쿼리를 데이터베이스로 한 번에 전송하여 실행합니다.
Insert와 Update 모두 이 addBatch + execute() 패턴을 동일하게 사용합니다. 다만 addBatch()를 호출하기 전에 어떤 조건이 필요한지는 두 작업이 다릅니다 — 이 차이는 뒤에서 각 장을 다룰 때 짚어보겠습니다.
성능 측정 방법론
이후 Batch Insert, Batch Update 각 장에서 제시하는 성능 측정 결과는 모두 아래와 같은 공통 방법론으로 산출되었습니다.
- 반복 측정: 각 데이터 구간(100건 ~ 10,000건)마다 총 5회 반복하여 측정했습니다.
- Warm-up 고려: 테스트 실행 시 첫 번째 회차는 결과에서 제외했습니다. 데이터베이스 커넥션 풀에서 커넥션을 처음 생성하는 초기 비용 등이 포함되어 결과가 왜곡되는 것을 방지하기 위함입니다.
- 평균값 산출: 첫 회차를 제외한 나머지 4회의 실행 시간을 합산하여 평균값을 산출함으로써 보다 신뢰성 있는 성능 데이터를 얻었습니다.
이 절에서는 방법론만 다룹니다. 구체적인 수치와 개선율은 각 장의 “성능 측정 결과”에서 제시합니다.
이제 이 준비 위에서, 먼저 Batch Insert부터 적용해보겠습니다.
Batch Insert 적용
기준선: JPA saveAll과 IDENTITY 전략
성능 비교의 기준선인 saveAll은 왜 Batch Insert가 되지 않는 걸까요? Hibernate에는 JDBC 레벨의 Batch 기능을 켜는 hibernate.jdbc.batch_size 설정이 있습니다. 이 설정을 활성화하면 SQL 구문을 드라이버 레벨에서 모았다가 executeBatch()로 일괄 전송하는데, 이 기능은 엔티티의 식별자 생성 전략에 따라 동작이 달라집니다.
SEQUENCE,TABLE, 할당식(Assigned등) 전략: 식별자를 애플리케이션이 미리 알 수 있으므로, 여러 엔티티의 INSERT를 Batch로 묶어 전송할 수 있습니다.IDENTITY전략 (MySQL의 기본형AUTO_INCREMENT): 식별자를 DB가 INSERT가 실행된 이후에야 채번합니다. Hibernate는 INSERT 직후getGeneratedKeys()로 채번된 ID를 받아와야 1차 캐시에 식별자를 등록할 수 있기 때문에, INSERT를 Batch로 묶을 수 없고 건마다 즉시 전송하는 수밖에 없습니다. 실제로 Hibernate는 IDENTITY 전략을 사용하는 엔티티에 대해 JDBC 배치를 스킵합니다.
MySQL에서는 네이티브 SEQUENCE를 제공하지 않아 대개 @GeneratedValue(strategy = GenerationType.IDENTITY) + AUTO_INCREMENT 조합을 사용하므로, JPA + MySQL + IDENTITY 조합에서는 saveAll을 아무리 호출해도 JDBC 레벨의 Batch Insert가 일어나지 않습니다. saveAll은 각 엔티티를 영속성 컨텍스트에 persist하며 건마다 개별 INSERT 구문을 전송할 뿐입니다.
IDENTITY 전략에서의 개선 여지는 hibernate.jdbc.batch_size 설정이 아닌, 드라이버 옵션(rewriteBatchedStatements=true)이나 아래에서 다룰 Querydsl-SQL의 addBatch처럼 식별자 채번을 요구하지 않는 쓰기 전용 경로로 전환하는 것입니다.
SQLQueryFactory 구성
BatchInsertService는 JPAQueryFactory, JdbcTemplate, WriterRepository, DataSource 총 4개의 의존성을 주입받습니다. 이 중 Batch Insert/Update에 실제로 사용되는 것은 dataSource입니다.
@Service
class BatchInsertService(
    private val jpaQueryFactory: JPAQueryFactory,
    private val jdbcTemplate: JdbcTemplate,
    private val writerRepository: WriterRepository,
    private val dataSource: DataSource
) {

    private val sqlQueryFactory: SQLQueryFactory by lazy {
        SQLQueryFactory(Configuration(MySQLTemplates()), dataSource)
    }

    // ...
}sqlQueryFactory는 메서드가 호출될 때마다 새로 만들지 않고, by lazy로 최초 한 번만 생성한 뒤 클래스 내에서 공유하는 인스턴스로 사용합니다. Insert와 Update 양쪽 메서드가 이 공유 인스턴스를 그대로 재사용합니다.
구현: executeBulkInsertWritersWithSql
@Transactional
fun executeBulkInsertWritersWithSql(writers: List<Writer>): Long {
    // 1. 테이블 메타데이터 정의
    val writerTable = RelationalPathBase(Writer::class.java, "writer", null, "writer")
    // 2. SQLQueryFactory (공유 인스턴스 사용)
    val insert = sqlQueryFactory.insert(writerTable)
    // 3. 데이터를 Batch에 추가
    for (writer in writers) {
        insert.set(QWriter.writer.name, writer.name)
        insert.set(QWriter.writer.email, writer.email)
        insert.set(QWriter.writer.score, 1)
        insert.set(QWriter.writer.reputation, 1.toDouble())
        insert.set(QWriter.writer.active, true)
        insert.addBatch() // 메모리에 쿼리 적재
    }

    // 4. 일괄 실행
    return insert.execute()
}name, email은 인자로 받은 writer의 값을 그대로 설정하고, score, reputation, active는 초기값으로 고정해서 취합니다. Insert에는 Update와 달리 where 조건이 필요 없습니다 — 새로운 row를 추가하는 작업이기 때문에 대상을 특정할 필요가 없습니다.
하나 중요한 점을 짚고 넘어가겠습니다.
SQLQueryFactory는 JPA의EntityManager가 아니라 주입받은DataSource에서 직접 커넥션을 얻어 쿼리를 실행합니다. 그래서 이 메서드에 붙은@Transactional(JPA 트랜잭션 매니저 기준)은 이 Batch 쿼리의 실행 커넥션과 바인딩되지 않습니다 — 즉, JPA 트랜잭션과 별개의 커넥션에서 실행되므로 JPA 트랜잭션 매니저 기준 원자성(롤백)은 보장되지 않습니다. Batch Insert/Update를 하나의 트랜잭션 경계 안에서 원자적으로 처리하려면TransactionAwareDataSourceProxy(DataSource를 스프링 트랜잭션 매니저에 참여시키는 래퍼)처럼 트랜잭션에 바인딩된 커넥션을 명시적으로 전달하거나, JdbcTemplate처럼 스프링이 트랜잭션에 참여시키는 커넥션 획득 경로를 사용해야 합니다.
rewriteBatchedStatements=true의 효과
MySQL을 사용하는 경우, JDBC 연결 URL에 rewriteBatchedStatements=true 옵션을 반드시 추가해야 합니다.
jdbc:mysql://localhost:3306/mydb?rewriteBatchedStatements=true이 옵션이 필요한 이유:
기본적으로 MySQL JDBC 드라이버는 addBatch()로 들어온 쿼리들을 개별적인 Insert 구문으로 전송합니다. 하지만 이 옵션을 활성화하면 드라이버 레벨에서 여러 개의 Insert 구문을 하나의 INSERT INTO ... VALUES (...), (...), (...) 형태의 Multi-Value Insert 구문으로 재작성(Rewrite)하여 전송합니다. 이를 통해 네트워크 패킷 수를 획기적으로 줄이고 데이터베이스의 파싱 비용을 절감하여 성능을 극대화할 수 있습니다.
처리 흐름:
옵션 유무에 따른 차이:
| 상황 | DB로 전달되는 SQL |
|---|---|
addBatch() 단독 | INSERT ... VALUES (a) × N번 |
addBatch() + rewriteBatchedStatements=true | INSERT ... VALUES (a),(b),(c) × 1번 |
rewriteBatchedStatements=true는 애플리케이션 코드 변경 없이 JDBC 드라이버 레벨에서 자동으로 변환해주므로, 옵션 하나만으로 Multi-Value INSERT의 성능 이점을 얻을 수 있습니다.
주의 —
max_allowed_packet과 청킹: 재작성된 단일 구문은 하나의 패킷으로 전송되므로, 데이터 건수·컬럼 수가 늘어나면max_allowed_packet(서버 기본값 64MB)을 초과할 수 있습니다. 초과하면 쿼리가 실패하거나 드라이버가 패킷을 분할해 전송하므로, 대량 적재 시에는 건수 기준(예: 수천 건 단위)으로 배치를 끊어 청킹하는 것이 안전합니다. 본 글의 측정(최대 10,000건)은 이 한도 내에서 수행되었습니다.
실제 전송 쿼리 확인: profileSQL=true
실제로 DB에 어떤 쿼리가 전송되는지 확인하려면 JDBC URL에 profileSQL=true(MySQL JDBC 드라이버의 디버그 로깅 옵션)을 추가합니다.
jdbc:mysql://localhost:3306/mydb?rewriteBatchedStatements=true&profileSQL=truerewriteBatchedStatements=true 일 때 — 10건이 하나의 Multi-Value INSERT로 전송됩니다.
[QUERY] insert into writer (name, email, score, reputation, active)
values ('name-5-1', 'email-5-1', 1, 1.0, 1),('name-5-2', 'email-5-2', 1, 1.0, 1), ... ,('name-5-10', 'email-5-10', 1, 1.0, 1)
rewriteBatchedStatements=false 일 때 — 건별로 개별 INSERT가 반복 전송됩니다.
[QUERY] insert into writer (name, email, score, reputation, active) values ('name-5-6', 'email-5-6', 1, 1.0, 1)
[QUERY] insert into writer (name, email, score, reputation, active) values ('name-5-7', 'email-5-7', 1, 1.0, 1)
[QUERY] insert into writer (name, email, score, reputation, active) values ('name-5-8', 'email-5-8', 1, 1.0, 1)
...profileSQL=true는 개발/테스트 환경에서 실제 전송 쿼리를 눈으로 검증할 때 유용하며, 운영 환경에서는 로그 부하로 인해 비활성화하는 것을 권장합니다.
DB 서버 입장에서의 차이
세 가지 방식이 DB 서버에서 어떻게 처리되는지 비교하면 성능 차이의 원인을 명확히 이해할 수 있습니다.
| 항목 | 단건 INSERT | JDBC Batch INSERT ( rewriteBatchedStatements=false) | Multi-Value INSERT ( rewriteBatchedStatements=true) |
|---|---|---|---|
| 방식 | 건당 1회 전송 | addBatch() 호출만 묶이고 전송은 건당 개별 실행 | 1개 구문(VALUES ...,...)으로 전송 |
| 네트워크 왕복 | N번 | N번 | 1번 |
| DB가 수신하는 구문 수 | N개 | N개 | 1개 |
| SQL 파싱 비용 | N번 | N번 | 1번 |
| 트랜잭션 커밋 오버헤드 | N번 (auto-commit 시) | N번 (auto-commit 시) | 1번 |
| DB 내부 잠금(Lock) 획득 | N번 | N번 | 1번 |
- 단건 INSERT:
saveAll처럼 동일한 커넥션 안에서 건마다 개별 INSERT 구문을 전송하는 방식 - JDBC Batch INSERT:
addBatch()+executeBatch()로 여러 구문을 애플리케이션 코드 차원에서는 하나로 묶어 호출하지만,rewriteBatchedStatements=true없이는 MySQL Connector/J가 이를 그대로 N번의 개별 INSERT로 전송·실행 — 네트워크 왕복과 DB 파싱·실행 횟수는 단건 INSERT와 동일 - Multi-Value INSERT:
rewriteBatchedStatements=true로 드라이버가INSERT INTO ... VALUES (...),(...),...형태의 단일 구문으로 변환하여 전송
JDBC Batch INSERT는 애플리케이션 코드에서 여러 구문을 모아 호출할 수 있게 해줄 뿐, rewriteBatchedStatements=true 없이는 네트워크 왕복과 DB 파싱·실행 횟수를 줄이지 못합니다 — 앞서 profileSQL 로그에서 확인했듯, 건별로 개별 INSERT가 그대로 전송됩니다. Multi-Value INSERT만이 네트워크 왕복과 DB 파싱·실행을 모두 1번으로 줄이기 때문에 데이터 양이 많을수록 단건/JDBC Batch INSERT와의 성능 차이가 커집니다.
성능 측정 결과 (Insert)
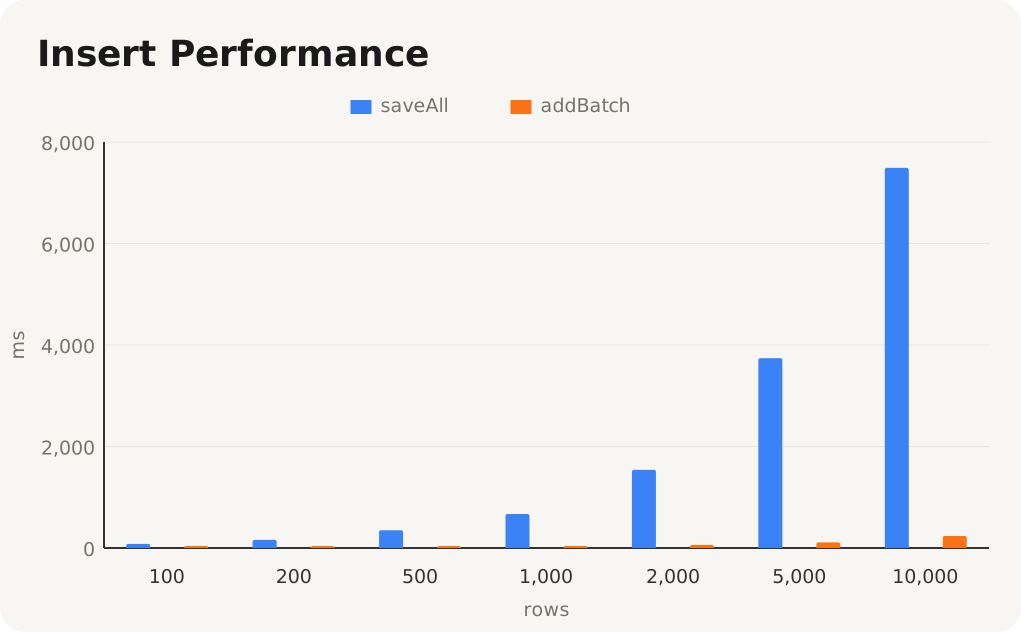
JPA saveAll과 Querydsl addBatch(rewriteBatchedStatements=true 적용, 앞서 표의 Multi-Value INSERT에 해당)를 사용했을 때의 성능 차이를 비교한 결과입니다. 데이터 개수가 늘어날수록 성능 차이가 확연하게 벌어지는 것을 확인할 수 있습니다.
| rows | saveAll (ms) | add batch (ms) | 성능 개선율 |
|---|---|---|---|
| 100 | 104 | 12 | 88.50% |
| 200 | 174.5 | 16 | 90.80% |
| 500 | 370.25 | 27.5 | 92.60% |
| 1,000 | 695 | 56 | 91.90% |
| 2,000 | 1,574 | 68 | 95.70% |
| 5,000 | 3,778 | 140 | 96.30% |
| 10,000 | 7,505 | 265 | 96.50% |
- saveAll: JPA Repository의 saveAll 메서드 사용
- add batch: Querydsl
SQLQueryFactory의addBatch+rewriteBatchedStatements=true사용 — 앞서 “DB 서버 입장에서의 차이” 표의 Multi-Value INSERT에 해당
10,000건 기준으로 약 96.5%의 성능 개선 효과가 있었습니다. saveAll이 약 7.5초 걸리는 작업을 Batch Insert로는 0.26초 만에 처리할 수 있습니다.
참고: 이 측정은 애플리케이션 서버와 데이터베이스가 동일한 로컬 환경(loopback)에서 수행된 결과입니다(Spring Boot 3.2.1, Querydsl 5.1.0, Kotlin 1.9.21, JDK 17 기준). Loopback 통신은 실제 네트워크 대비 레이턴시가 거의 없는 이상적인 조건임에도 불구하고 이 정도의 성능 차이가 발생합니다. 실제 운영 환경처럼 애플리케이션 서버와 DB 서버가 별도의 네트워크에 위치한다면, 건별로 Insert 쿼리를 전송하는
saveAll방식은 네트워크 왕복 비용이 Insert 건수만큼 누적되어 성능 차이가 훨씬 더 크게 벌어질 수 있습니다.
Batch Update 적용
앞서 Querydsl-SQL로 Insert 성능을 개선했습니다. 이번에는 같은 접근을 Update에도 적용해보겠습니다. Insert와 동일하게 addBatch + execute() 패턴을 사용하지만, Update에는 수정 대상을 특정하는 where 조건이 반드시 필요하다는 차이가 있습니다.
기준선: JPA Dirty Checking의 한계
JPA의 일반적인 Update 패턴은 엔티티를 조회하여 영속성 컨텍스트에 올린 뒤, 필드를 변경하고 트랜잭션이 커밋될 때 변경 감지(Dirty Checking)를 통해 UPDATE 쿼리를 실행하는 방식입니다. 아래는 이번 성능 비교의 기준선(baseline)으로 사용하는 updateWriters 메서드입니다.
@Transactional
fun updateWriters(writers: List<Writer>) {
    for (writer in writers) {
        writer.name = "updated"
        writerRepository.save(writer) // dirty checking → 트랜잭션 커밋 시 건별 UPDATE 발생
    }
}
편리한 방식이지만, 1,000개의 데이터를 수정하면 1,000번의 UPDATE 쿼리가 데이터베이스로 전송됩니다. 대량 수정 작업에서는 이 점이 심각한 성능 저하의 원인이 됩니다.
구현: executeBulkUpdateWritersWithSql
Update에서 Batch에 적재할 데이터는 Writer 엔티티 전체가 아니라, 수정에 필요한 필드만 담은 별도의 데이터 클래스로 표현합니다.
data class WriterUpdate(
    val id: Long,
    val name: String,
)
이 WriterUpdate를 받아 name 필드 하나만 갱신하는 것이 executeBulkUpdateWritersWithSql의 구현입니다.
@Transactional
fun executeBulkUpdateWritersWithSql(writers: List<WriterUpdate>): Long {
    // 1. 테이블 메타데이터 정의
    val writerTable = RelationalPathBase(Writer::class.java, "writer", null, "writer")
    // 2. SQLQueryFactory (공유 인스턴스 사용)
    val update = sqlQueryFactory.update(writerTable)
    // 3. 데이터를 Batch에 추가
    for (writer in writers) {
        val id = requireNotNull(writer.id) { "Writer id must not be null" }
        update
            .set(QWriter.writer.name, writer.name)
            .where(QWriter.writer.id.eq(id))
            .addBatch() // 메모리에 쿼리 적재
    }

    // 4. 일괄 실행
    return update.execute()
}
Batch Insert와 Batch Update는 동일한 addBatch + execute() 패턴을 사용하지만, 중요한 구조적 차이가 있습니다.
| 항목 | Batch Insert | Batch Update |
|---|---|---|
where 조건 | 불필요 | 필수 |
| 테이블 참조 | RelationalPathBase | RelationalPathBase (동일) |
| 컬럼 참조 | QWriter.writer.* | QWriter.writer.* (동일) |
| id 처리 | 없음 | requireNotNull 필요 |
가장 중요한 차이는 where 조건입니다. where 없이 addBatch()를 호출하면 해당 UPDATE는 테이블 전체를 대상으로 실행되어 의도치 않은 전체 UPDATE가 발생할 수 있습니다. 반드시 where(QWriter.writer.id.eq(id))와 같이 대상 row를 특정해야 합니다. 또한 id는 nullable 타입이므로, requireNotNull로 null을 방어한 뒤 사용해야 컴파일 시점 타입 안전성이 보장됩니다.
profileSQL 로그로 batch 동작 검증
addBatch를 사용하면 SQL 내용 자체는 dirty checking과 동일하게 UPDATE writer SET ... WHERE id = ? 형태입니다. 쿼리 내용만으로는 실제로 batch가 동작하는지 구분하기 어렵습니다.
실제 전송 방식의 차이는 JDBC URL에 profileSQL=true를 추가하면 로그로 확인할 수 있습니다.
jdbc:mysql://localhost:3306/mydb?rewriteBatchedStatements=true&logger=Slf4JLogger&profileSQL=true케이스 1 — dirty checking (N번 통신)
[QUERY] update writer set active=1,email='email-1',name='updated'... where id=1
        [at ProxyPreparedStatement.executeUpdate]
[FETCH] [at ProxyPreparedStatement.executeUpdate]
[QUERY] update writer set active=1,email='email-2',name='updated'... where id=2
        [at ProxyPreparedStatement.executeUpdate]
[FETCH] [at ProxyPreparedStatement.executeUpdate]
[QUERY] update writer set active=1,email='email-3',name='updated'... where id=3
        [at ProxyPreparedStatement.executeUpdate]
[FETCH] [at ProxyPreparedStatement.executeUpdate]
...executeUpdate가 건마다 호출되어 [QUERY] + [FETCH] 쌍이 건수만큼 반복됩니다. 10건이면 DB 서버로 10번 왕복합니다.
로그에
name외에active,@DynamicUpdate를 명시하지 않는 한 변경 감지 시 매핑된 컬럼 전체를 UPDATE 문에 포함하는 것이 기본 동작이기 때문입니다.
케이스 2 — addBatch (1번 통신)
[QUERY] update writer
set name = 'updated'
where writer.id = 1;update writer
set name = 'updated'
where writer.id = 2;update writer
set name = 'updated'
where writer.id = 3;
...
update writer
set name = 'updated'
where writer.id = 10;
[QUERY] 로그가 1개만 출력됩니다. 세미콜론으로 구분된 모든 쿼리가 하나의 패킷으로 전송되며, 10건이든 10,000건이든 DB 서버로 1번만 왕복합니다. 다만 세미콜론 결합 구문도 하나의 패킷에 담기므로, 건수가 매우 크면 max_allowed_packet 한도에 걸릴 수 있습니다 — 이 경우 Multi-Value INSERT와 마찬가지로 배치를 나눠 청킹하면 됩니다.
구분 포인트 요약
| 구분 기준 | dirty checking | addBatch |
|---|---|---|
| 메서드명 | executeUpdate | executeBatch ([QUERY] 수로 판단) |
[QUERY] 로그 수 | N개 | 1개 |
[FETCH] 존재 | 건마다 존재 | 없음 |
| 쿼리 형태 | 쿼리 1개씩 | ;로 이어진 멀티 쿼리 |
profileSQL=true만 붙이면 로그 줄 수와 메서드명만으로 의도한 대로 batch가 동작하고 있는지 즉시 확인할 수 있습니다.
성능 측정 결과 (Update)
JPA Dirty Checking과 Querydsl addBatch를 사용했을 때의 성능 차이를 비교한 결과입니다.
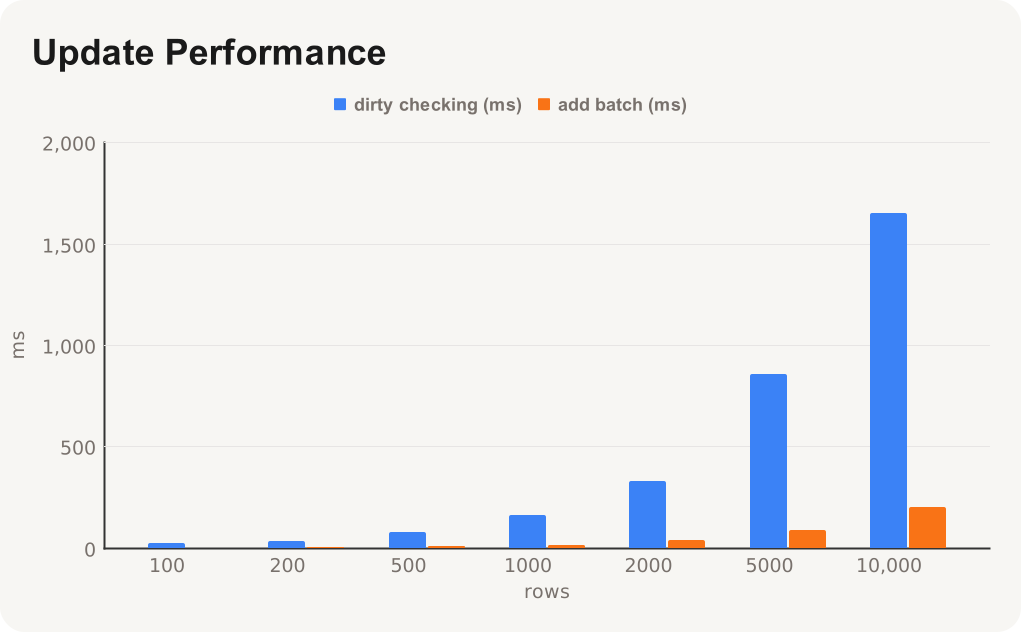
| rows | dirty checking (ms) | add batch (ms) | 성능 개선율 |
|---|---|---|---|
| 100 | 265.5 | 28.5 | 89.3% |
| 200 | 368.5 | 45.5 | 87.7% |
| 500 | 808.75 | 103.5 | 87.2% |
| 1,000 | 1,647.25 | 191.5 | 88.4% |
| 2,000 | 3,315.0 | 392.0 | 88.2% |
| 5,000 | 8,593.5 | 928.25 | 89.2% |
| 10,000 | 16,530.75 | 2,063.0 | 87.5% |
- bar (dirty checking): JPA
save(writer)를 루프에서 건별 호출 — UPDATE N번 개별 전송 - line (add batch): Querydsl SQLQueryFactory의 addBatch — N개의 UPDATE를 1번의 네트워크 왕복으로 전송
10,000건 기준으로 약 87.5%, 1,000건 기준으로는 88.4%의 성능 개선 효과가 있었습니다.
참고: 이 측정 역시 애플리케이션 서버와 데이터베이스가 동일한 로컬 환경(loopback)에서 수행된 결과입니다(Spring Boot 3.2.1, Querydsl 5.1.0, Kotlin 1.9.21, JDK 17 기준). Loopback 통신은 실제 네트워크 대비 레이턴시가 거의 없는 이상적인 조건임에도 불구하고 이 정도의 성능 차이가 발생합니다. 실제 운영 환경처럼 애플리케이션 서버와 DB 서버가 별도의 네트워크에 위치한다면, 건별로 전송하는 dirty checking 방식은 네트워크 왕복 비용이 쿼리 수만큼 누적되어 성능 차이가 훨씬 더 크게 벌어질 수 있습니다.
Insert는 saveAll 대비 10,000건 기준 96.5%, Update는 dirty checking 대비 10,000건 기준 87.5% 개선되었습니다. 두 수치를 나란히 놓고 “Insert가 Update보다 우수하다”고 결론짓고 싶어질 수 있지만, 이는 오도하는 비교입니다. Insert는 saveAll의 IDENTITY 단건 Insert를 기준선으로 삼고, Update는 dirty checking N-update를 기준선으로 삼는, 서로 다른 연산·서로 다른 기준선을 가진 두 개의 독립적인 실험이기 때문입니다. 실제로 100건 구간만 보면 Update(89.3%)가 Insert(88.5%)보다 개선율이 더 높게 나오기도 합니다. 두 수치는 배수로 통일하거나 비교표로 나란히 놓지 않고, 각자의 절대값으로만 읽어야 합니다.
마치며
어드민 페이지의 단순한 페이징에서 출발한 이 글은, 대량 데이터 처리의 병목을 읽기와 쓰기 양쪽에서 차례로 해결하며 여기까지 왔습니다.
읽기. Count 쿼리 병목은 Slice로 걷어내거나 별도 Count 쿼리와 코루틴 병렬 처리로 완화했고, 그럼에도 남는 offset의 구조적 한계는 커서 기반 페이지네이션으로 해결했습니다. 세 가지 방식은 모두 Querydsl4RepositorySupport의 공통 함수로 제공되며, 화면 요구사항에 따라 중간 정리의 선택 기준표를 참고해 고르면 됩니다.
쓰기. JPA의 saveAll과 Dirty Checking은 각각 편리한 API지만, 데이터 양이 늘어나는 순간 서로 다른 이유로 성능의 벽에 부딪힙니다. 두 경우 모두 Querydsl-SQL의 SQLQueryFactory와 addBatch로 해결할 수 있었습니다. Insert는 where 없이 여러 row를 한 번에 밀어 넣고, Update는 where로 대상을 특정하며 여러 row를 한 번에 갱신한다는 차이가 있을 뿐, 근본적으로는 같은 패턴입니다.
Batch 처리를 실무에 적용할 때 공통으로 확인해야 할 체크리스트를 정리합니다.
- 트랜잭션/커넥션 주의: Querydsl-SQL은 주입받은
DataSource에서 직접 커넥션을 얻으므로,@Transactional(JPA 트랜잭션 매니저 기준)은 이 Batch 쿼리에 적용되지 않습니다.addBatch()스스로는execute()시점에 일괄 전송일 뿐 원자성을 보장하지 않으므로, 원자적 처리가 필요하다면TransactionAwareDataSourceProxy처럼 트랜잭션에 바인딩된 커넥션을 명시적으로 전달해야 합니다. rewriteBatchedStatements=true필수: 이 옵션 없이는addBatch()가 JDBC Batch 수준에 머물러, DB 파싱·실행 횟수를 줄이는 Multi-Value 효과를 얻지 못합니다.- 배치 크기는
max_allowed_packet이내로: Multi-Value INSERT든 세미콜론 결합 UPDATE든 재작성된 구문은 하나의 패킷으로 전송됩니다. 건수·컬럼 수가 많으면 이 한도를 초과해 쿼리가 실패할 수 있으므로, 대량 적재 시 배치를 적절한 단위(예: 수천 건)로 나눠 청킹하세요. - Update는
where절이 필수:where없는addBatch()는 테이블 전체를 대상으로 UPDATE를 실행할 수 있는 위험한 코드입니다. 반드시id와 같은 식별자로 대상 row를 특정해야 합니다. profileSQL=true는 개발 환경 전용: batch 동작을 검증하는 데는 유용하지만, 운영 환경에서는 로그 부하가 커지므로 비활성화해야 합니다.
읽기는 offset을 커서로 바꿔 어느 위치에서든 실행 계획을 일정하게 유지했고, 쓰기는 건별 전송을 Batch로 묶어 네트워크 왕복과 파싱 비용을 줄였습니다. 접근은 다르지만 건수에 비례해 누적되는 비용 구조를 끊는다는 원리는 같습니다. 대량 데이터를 다루는 배치성 작업이 있다면, 새로운 라이브러리를 도입하기 전에 이미 프로젝트에 있는 Querydsl과 Querydsl-SQL로 어디까지 해결할 수 있는지 먼저 검토해 보시기를 권장합니다.
참고 자료
- Querydsl GitHub - AbstractJPAQuery#fetchCount Javadoc (
fetchCount()Deprecated 사유: 복잡한 쿼리에서 카운트 쿼리 재작성의 한계와 메모리 폴백에 따른 성능 페널티) - Querydsl 5.0.0 API Docs - Deprecated List (Deprecated된 Querydsl API 전체 목록 —
fetchCount(),fetchResults()등의 공식 Deprecated 근거) - Hibernate User Guide - 3.7.10. Using IDENTITY columns (“Hibernate will not be able to batch INSERT statements for the entities using the IDENTITY generation” — IDENTITY 전략이 JDBC 배치를 막는 공식 근거)
- Hibernate User Guide - 26.4. Identifier generation (IDENTITY는 post-insert 전략으로 INSERT가 실행된 이후에야 식별자를 알 수 있고,
persist()/save()시점에 즉시 INSERT가 수행된다는 안내) - Hibernate User Guide - 29.4.1. Best Practices — Identifiers (“IDENTITY generators disables JDBC batching for INSERT statements” — SEQUENCE 우선 권장 및 MySQL처럼 SEQUENCE 미지원 DB에서만 IDENTITY 사용 안내)
- MySQL 8.4 Reference Manual - Server System Variables: max_allowed_packet (Multi-Value 재작성 구문이 하나의 패킷으로 전송되므로 대량 적재 시 이 한도와 배치 청킹을 함께 고려해야 함)